push-lab
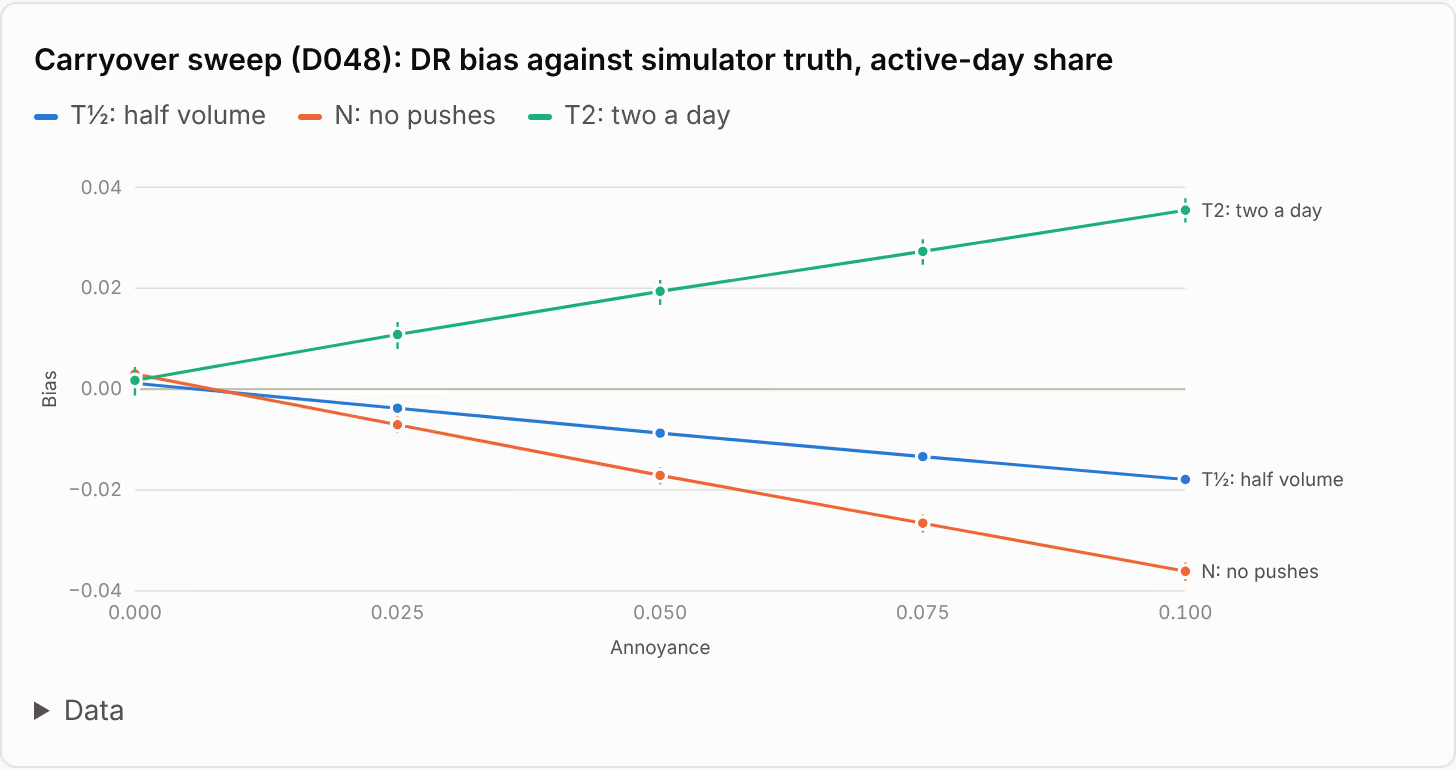
一个推送通知推荐的离线实验室,基于公开数据,覆盖召回、排序、发送量和发送时段;没有线上流量,所以每个结果都标明它可信到什么程度。在 Duolingo 随机化的通知日志上(A 级),模板 bandit 比均匀选择使每条通知两小时内的完成率高 0.00174(0.00126 到 0.00221)。
下面每个项目的仓库里都有测试,以及决策记录或预注册文件。
一个推送通知推荐的离线实验室,基于公开数据,覆盖召回、排序、发送量和发送时段;没有线上流量,所以每个结果都标明它可信到什么程度。在 Duolingo 随机化的通知日志上(A 级),模板 bandit 比均匀选择使每条通知两小时内的完成率高 0.00174(0.00126 到 0.00221)。
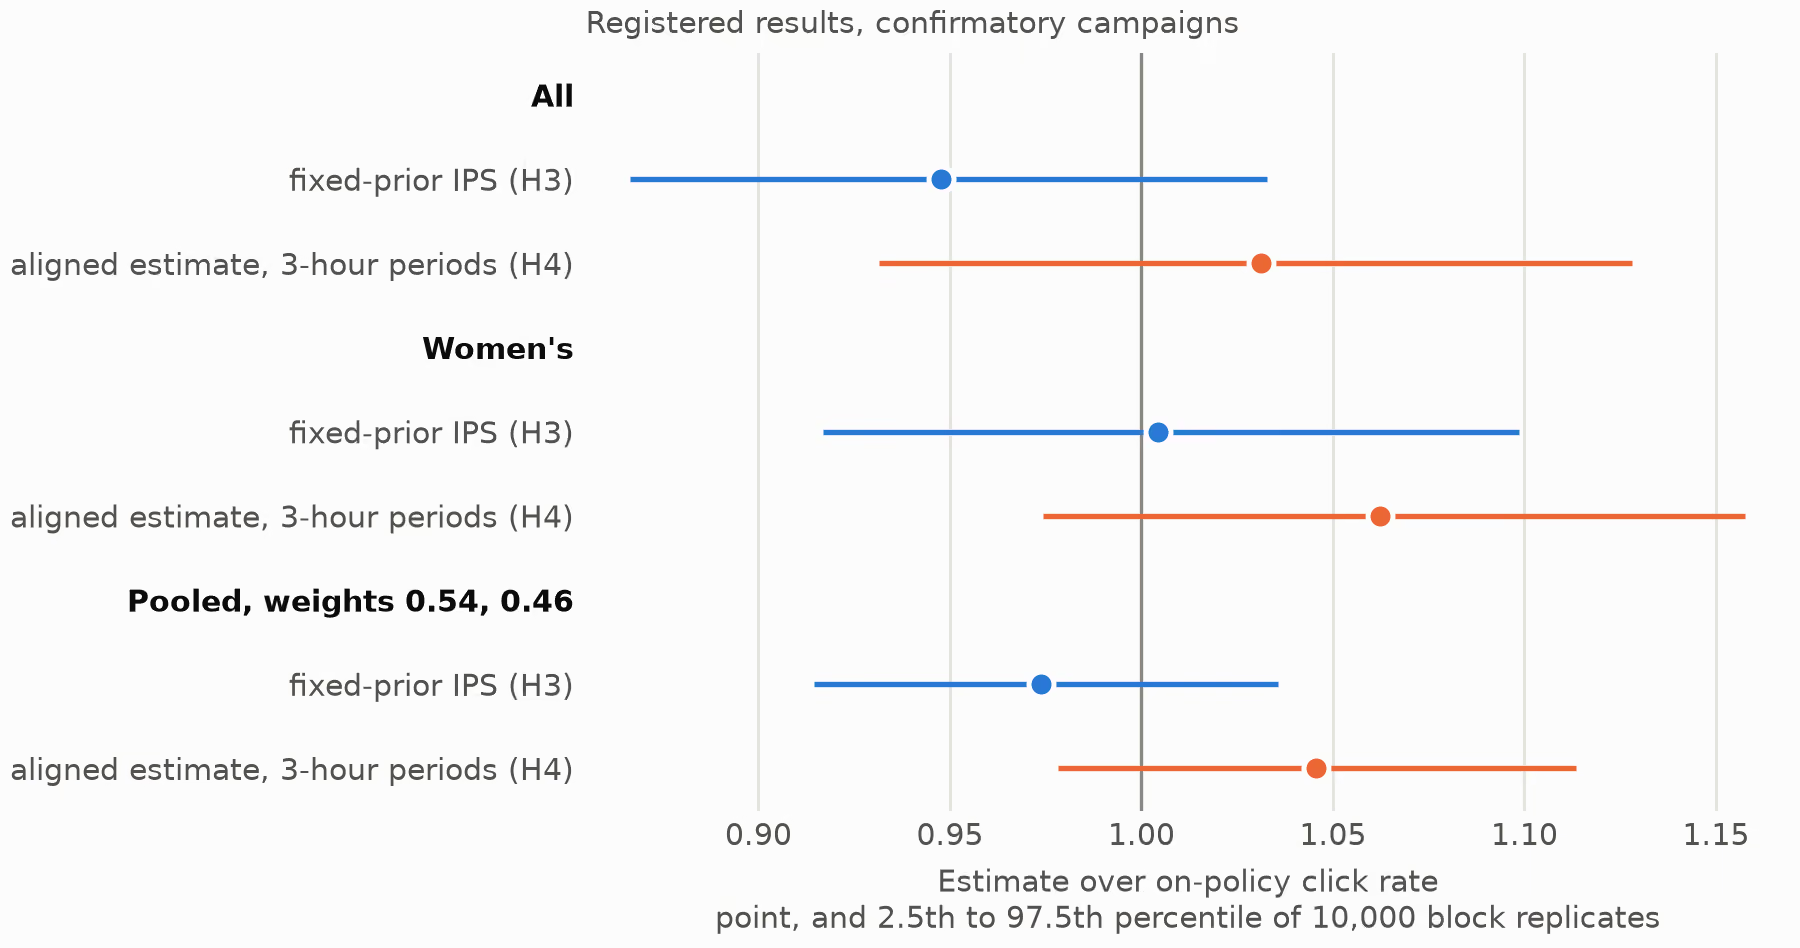
对已发表的离策略评估结果做预注册检验。第一项研究重测 Open Bandit 基准:在两个确认性活动上,以 10 分钟时间块为重采样单位时,标准估计没有显示出低于在线点击率。
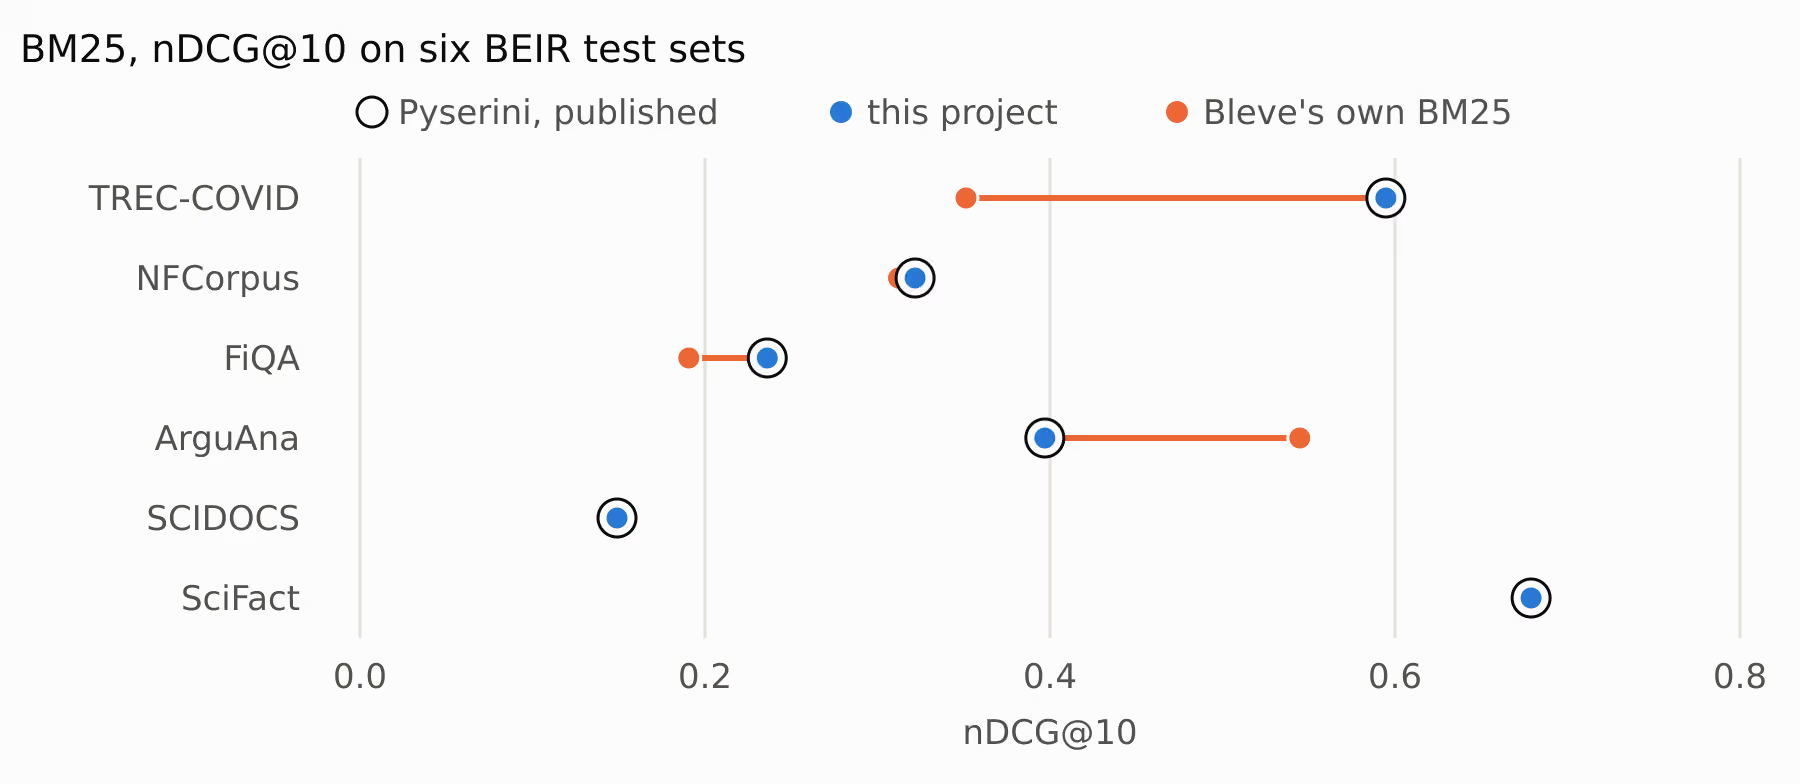
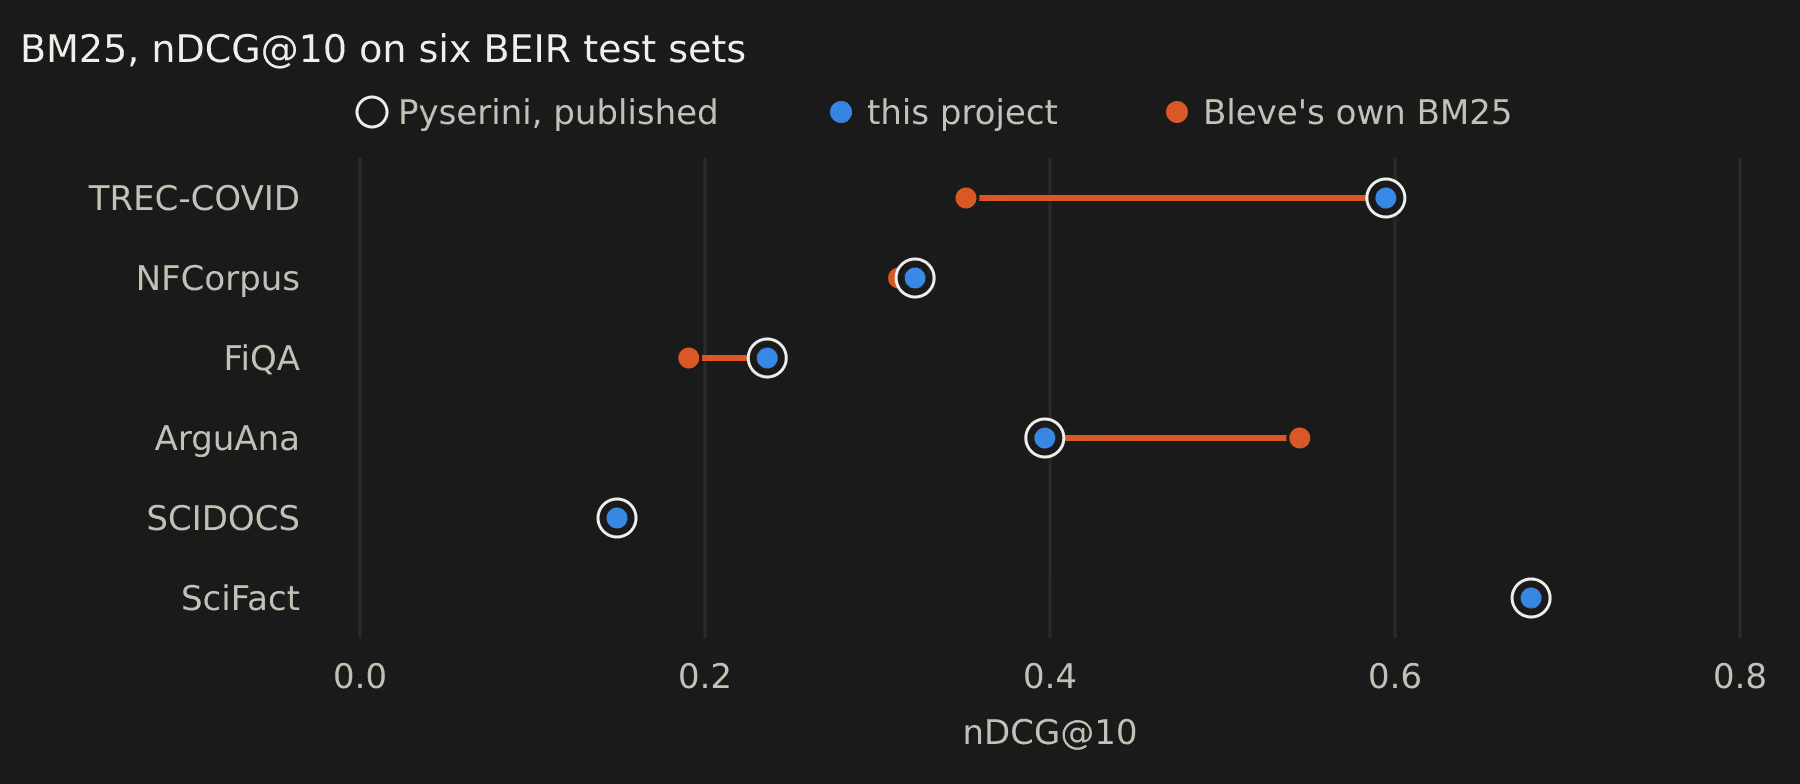
用 Go 实现的 BM25 和稠密检索,其中 BM25、用精确搜索的稠密检索和融合各自对照 Pyserini 为 BEIR 公布的数字验收。BM25 在六个数据集上的 nDCG@10 和 Recall@100 与公布值四位小数相同。BGE-base 加精确搜索在六个数据集上的 nDCG@10 相差都不超过 0.0006,除 TREC-COVID 外不超过 0.0004。在此基础上的一项预注册研究发现:ef 相同时,HNSW 造成的 nDCG@10 损失随模型而变;每个模型都搜索到相同的近邻召回率 0.95 时,就不再随模型而变。
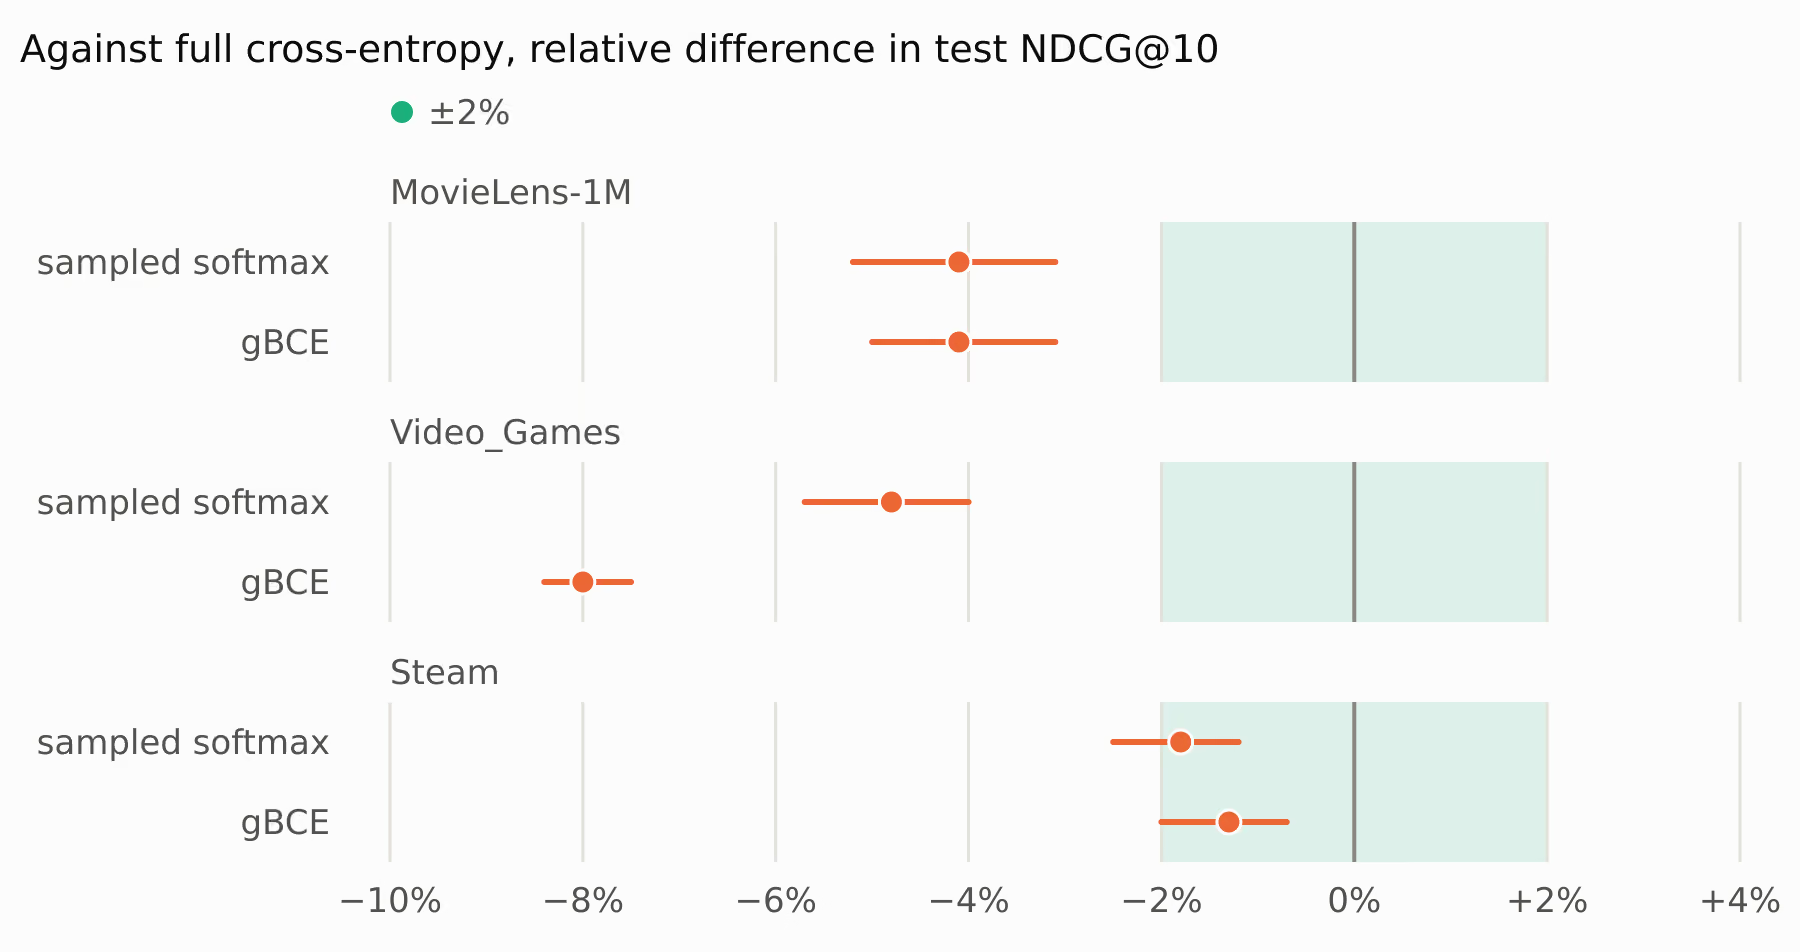
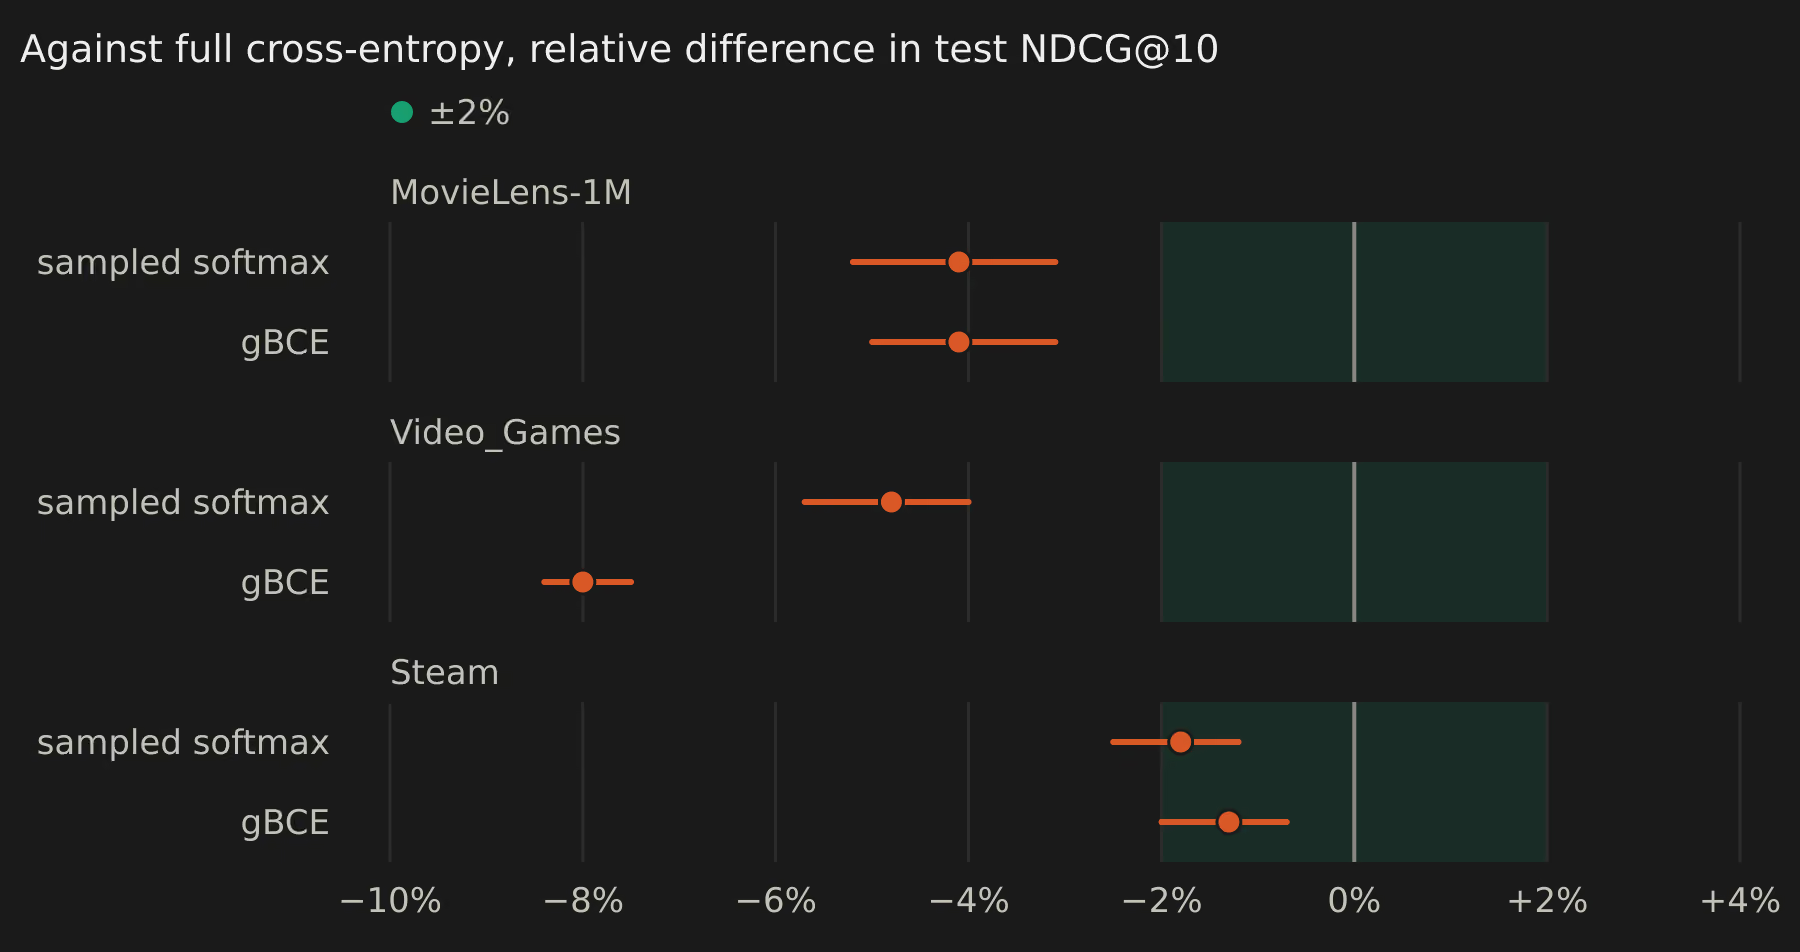
对 Transformer 序列推荐模型 SASRec、BERT4Rec 和 gSASRec 的预注册研究:各组调参预算相同,每组 5 到 10 个种子,在全部物品上排序评测,在一块租用的消费级 GPU 上进行。在 MovieLens-1M、Video_Games 和 Steam 上,用完整交叉熵训练的 SASRec 领先 BERT4Rec 和 gSASRec,用 BCE 加一个负样本训练的 SASRec 比它低 2% 以上。MovieLens-1M 的测试目标在正式运行之前已被锚点检查读过。MovieLens-20M 还没有结果。
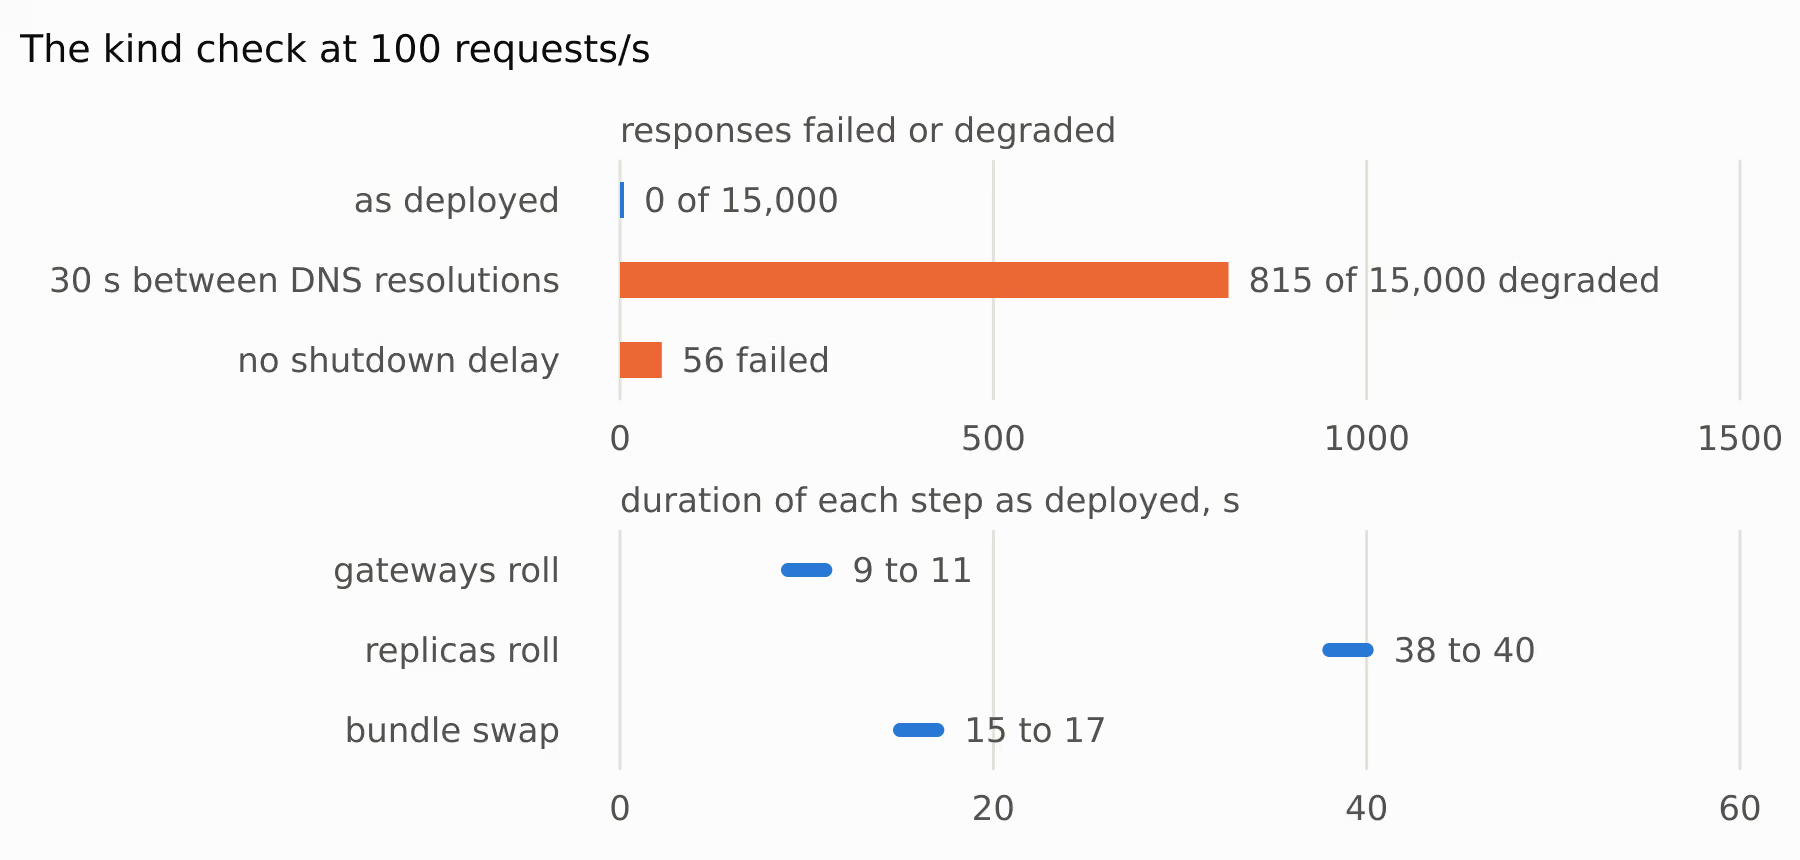
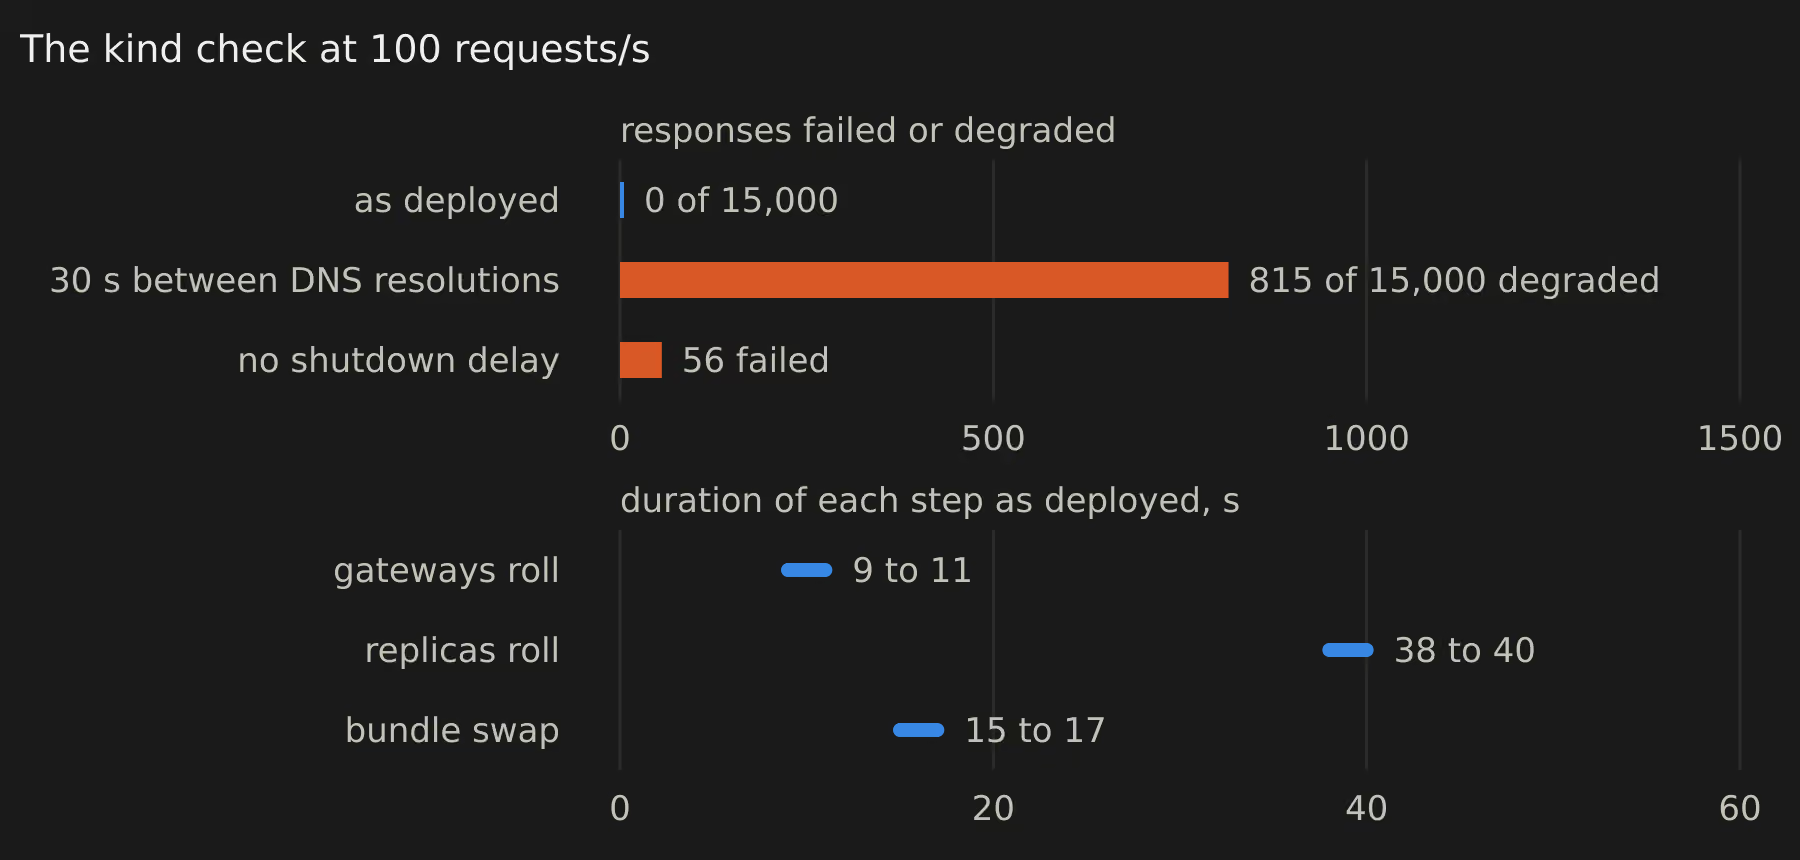
用 Go 写的推荐服务系统:召回、特征、排序和重排在同一个 HTTP 接口后面,物品向量分片放在 gRPC 副本上。在 kind 集群里每秒 100 个请求下,经过网关滚动重启、副本滚动重启和一次换包,15,000 个响应里没有一个失败或降级;各阶段的时间预算设为 100 ms。
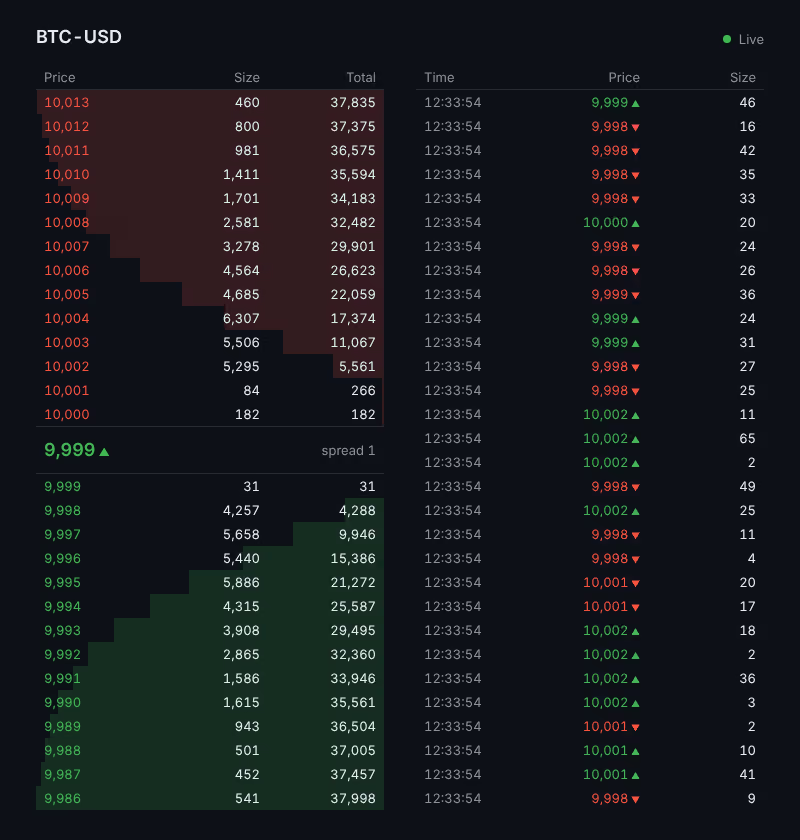
用 Go 写的限价订单簿撮合引擎:价格优先、时间优先,提供 REST 和 WebSocket 接口,重放命令日志能还原出同一本订单簿。
端到端加密的文件分享服务,服务端用 Go,前端用 React:文件在浏览器里加密,密钥只放在链接中浏览器不会发出的那一部分,服务器只保存它读不了的密文。
一个回测平台,用来判断一个策略是否很可能过拟合:先做参数搜索,再用滚动前推分析、清洗交叉验证、回测过拟合概率和紧缩夏普比率来评判搜出的最优参数。
一款面向 macOS 和 Windows 的个人记账桌面应用,所有数据都存在本机的加密数据库里,应用不发出任何网络请求。