push-lab
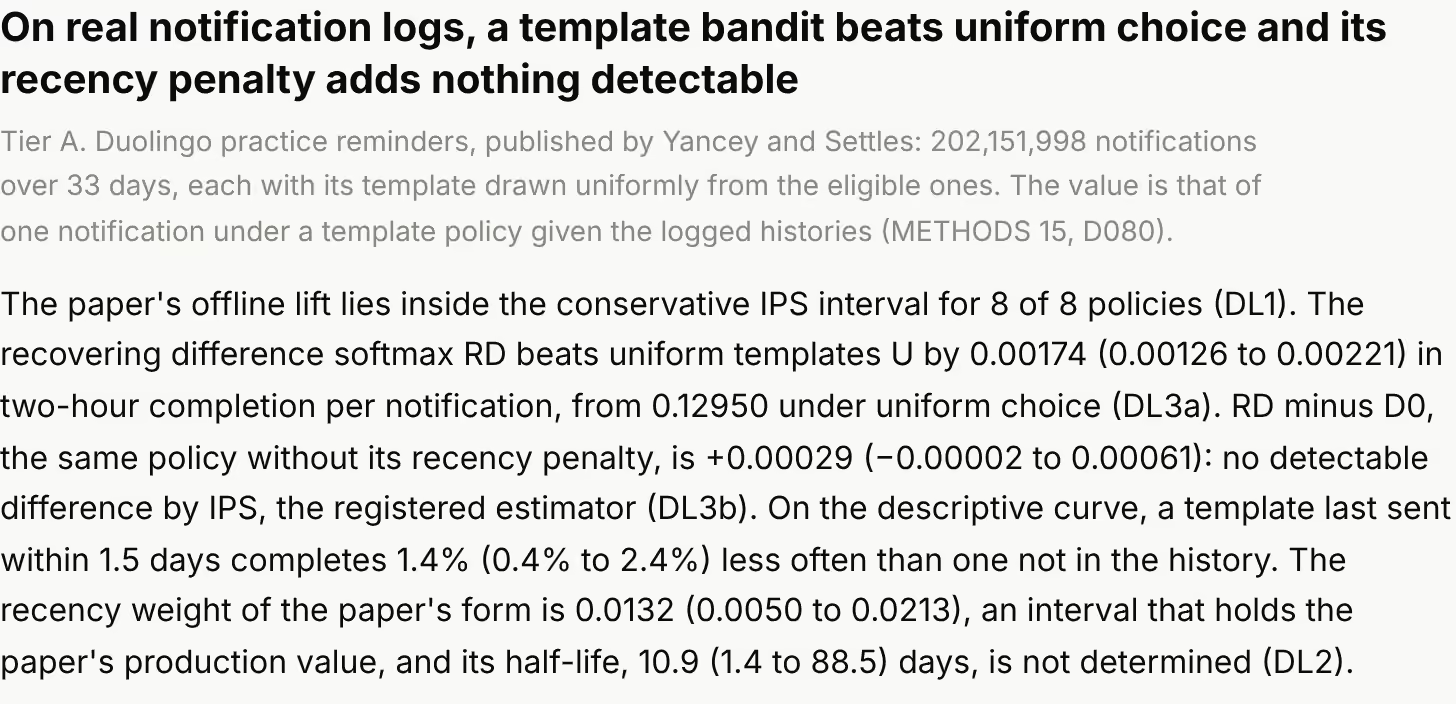
一个推送通知推荐的离线实验室,基于公开数据,覆盖召回、排序、发送量和发送时段;没有线上流量,所以每个结果都标明它可信到什么程度。在 Duolingo 随机化的通知日志上(A 级),模板 bandit 比均匀选择使每条通知两小时内的完成率高 0.00174(0.00126 到 0.00221)。
关键指标
- Duolingo 随机化日志上,模板 bandit 相对均匀选择在每条通知两小时内完成率上的提升(0.00126 到 0.00221,跨天取保守区间);它的新近惩罚项没有可检测的增益,+0.00029(−0.00002 到 0.00061)
- +0.00174
- IPS 在 Open Bandit 完整活动上估出的点击率与已知真值之比。登记的区间按曝光重采样,为 0.815 到 0.966,不含真值,没有估计器通过检验;事后按 10 分钟时间块重采样,区间为 0.789 到 1.004
- 0.891
- 在模拟器的基准设定下,每天一条推送相对于不发送,日活跃用户占比的变化(−2.4% 到 −2.2%)
- −2.3%
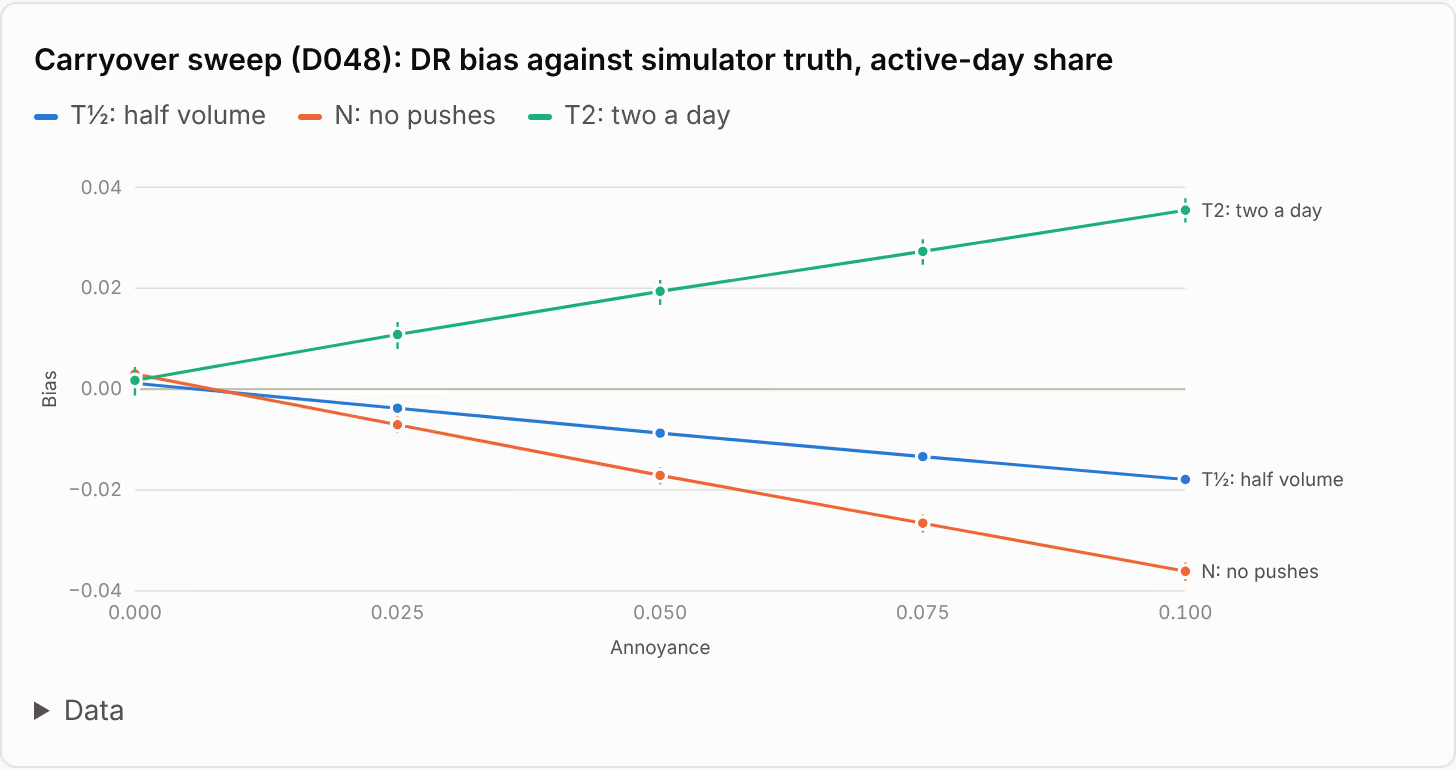
- 在这些设定中,只发一半推送的门控策略胜过每天推送;它在 19 个设定中落败,去掉厌烦效应后一个也赢不了
- 43 / 64
前两个数是 A 级证据,基于随机化的真实数据:第一个是在记录的历史下对一条通知给策略打分,第二个是对估计器本身的度量。其余两个是 C 级证据,只在模拟器里成立,要结合对模拟器假设的参数扫描来读。括号里是 95% 区间;逐个设定的结论只基于一次模型拟合。在一项登记的长周期研究中,模拟世界只有一个,用户 5,000 个,估计器 SMIS 在项目的探索日志上,于 8 个设定中的 6 个里偏向每天一条推送而非不推送,与真实情况相反(C 级);该研究的主要标签只在基准设定下读取。IPS 按 10 分钟时间块的区间,这里是 0.789 到 1.004,ope-checks 页上是 0.790 到 1.005:两个项目是分开各自跑的,点估计也不相同(0.8909 和 0.8913)。 结果摘要
问题与目标
push-lab 用公开数据和四个 CPU 核心搭起一套完整的推送通知推荐管线:带近似最近邻索引的双塔召回,粗排和精排两级排序,增益模型,以及决定发不发、几点发、用哪条文案的投放策略。结果以一份静态报告和一个 notebook 呈现。
项目的核心叙事在模拟开始前就作为假设预注册:每天给所有人推送排第一的内容,第一周点击最多,到第四周却会因厌烦和退订流失用户;只在预测增益够高时才发送、并受发送量预算约束的策略,能留住更多活跃用户。所有比较都预先定好,结果如实报告,叙事中没有成立的部分也照样报告。
端到端的叙事是基于短视频推荐数据的模拟,增益实验用的是邮件和广告数据,Duolingo 的日志只随机化每条通知的模板。因此每个结果都标了证据等级:基于随机化真实数据的为 A 级;由先经已知答案验证过的估计器给出的离策略估计为 B 级;来自模拟器并附有敏感性扫描的为 C 级。
架构
公开数据集按固定的校验和下载并转成 Parquet,原始数据从不提交。双塔召回配合 faiss 索引在 KuaiRand 上生成候选池,双塔分数保留前 N 个,再由 LightGBM 精排选出一条推送要带的内容。投放策略在发送量预算之下决定发不发、几点发、用哪条文案;它在一个推送模拟器里运行,模拟器的响应模型用 KuaiRand 的随机曝光数据拟合,各项假设都做参数扫描。模拟器的探索日志一方面用来拟合策略的增益门控,一方面交给离策略估计器,这些估计器另外在 Open Bandit 数据集上做过检验。增益模型在 Hillstrom 和 Criteo 两个随机化实验上检验,模板策略则在 Duolingo 随机化的通知日志上离线打分。每个环节都把结果写成 JSON,报告只读取这些文件,并给每个数字标上证据等级。
关键决策
-
D002 只做离线评估,并划分证据等级
没有线上流量,所以每个结果都属于三个证据等级之一:A 级来自随机化的真实数据;B 级是离策略估计,所用估计器先经过已知答案的检验;C 级是附带敏感性扫描的模拟器结果。已发表的通知系统报告的线上效果都很小,约为日活跃用户的 0.1% 到 0.5%,而它们的离线估计与线上结果在最长周期的指标上最不一致,所以模拟出的效果大小从不被当成真实效果来呈现。
-
D009 发送量控制与排序分开
参照 Zhao 等人(2018)的做法,排序模型决定发什么,策略决定发不发,改动其中一个不会干扰对另一个的评估。增益门控的阈值和预算约束的拉格朗日乘子是同一个对偶变量。只有当每多发一条的收益都比上一条少时,单个乘子才是最优的,而用户厌烦可能打破这个条件;因此有一个测试在小规模实例上把分配结果和穷举比对,并记录了一个条件不成立的例子。
-
D013 增益门控在模拟器内部学习
在 Hillstrom 或 Criteo 上训练的模型无法给 KuaiRand 的用户打分,两边的特征和干预都不一样。所以模拟器先运行一个 ε-贪心探索策略,在发或不发、发送时段和模板之间随机探索,门控就在这些日志上拟合;同样的日志也让离策略估计器对每个目标策略都有足够的覆盖。增益模型在真实实验上的结果用来验证方法本身,属于 A 级;门控的结果属于 C 级。
-
D014 发送时段策略不读取模拟器的活跃画像
如果发送时段策略和模拟器用的是同一份活跃画像,策略就会凭构造本身胜出。模拟器用的是每个用户 4 月 22 日到 5 月 8 日的活跃情况,策略则根据 4 月 9 日到 21 日的数据自行估计画像,参数扫描还会在此之上加入偏移和噪声。
-
D049 报告和 README 由结果文件生成
报告构建只读取
results/*.json,生成静态报告和 README 里的数字,这些数字放在自动生成的标记之间。每个数字都经过同一个按文件和键路径的查找、同一个格式化函数,并有测试检查文字模板里不含任何数字;README 与结果文件对不上时,CI 就会失败。报告只用标准库,图表是内联 SVG,不含脚本,并且只有在同一个提交的 CI 通过后才发布。
难点与解法
-
精排反而排得更差
预注册的检验预期 LightGBM 精排会胜过它所细化的双塔分数;结果在 KuaiRand 的随机曝光数据上,它的点击 GAUC 是 0.545,双塔分数是 0.598。训练和评估用的列、类型和特征顺序都一致,精排在它自己的验证集上也确实胜出,所以反转出现在从线上推荐系统的曝光数据换到随机曝光数据的时候。精排倚重的平滑点击率是在点击率 53% 的曝光数据上学到的,而随机曝光的点击率只有 17.7%,这些特征在那里几乎没有信号,简单的曝光计数反而更有用。超参数保持预注册时的设定,对精排的任何改动都作为单独的变体报告。
-
数据太少时通过的检验
要得到 B 级结果,需要一个估计器能在真实日志上还原已知的策略价值。在 Open Bandit 的小样本上,随机日志里只有 46 次点击,IPS 和 DR 通过了预注册的判定规则。完整的男装活动有 50 倍的点击,在那里没有一个估计器通过:IPS 估出已知点击率的 0.891,DR 估出 0.897,登记的区间按曝光重采样,都不含真值,所以项目没有 B 级结果。实际部署的策略并不是目标所假定的固定先验;按日志中的实际频率重新加权后,IPS 升到 0.917,变化为 +0.026,区间(−0.004 到 0.059)包含 0,所以这份数据无法说明差距来自哪里。在这个过程中,bootstrap 的重抽样单位也从行改成了曝光,因为每次曝光占三行。曝光在这份日志里也不独立:事后按 10 分钟时间块重采样,IPS 的区间(0.789 到 1.004)和 DR 的区间(0.796 到 1.006)都包含真值,变化的区间是 −0.021 到 0.074。登记的判定不变,没有估计器被当作通过了检验。
-
意外重合的随机数流
NumPy 的种子序列会忽略末尾的零,所以
default_rng([s, 0, 0])和default_rng(s)生成的随机数完全相同。探索策略用种子、日期和时段作为随机数的键,于是只要两个种子相同,第一天第一个时段的随机数就正好是模拟器自己的打开抽样;在一次合成数据的运行中,这让该时段的打开率从 0.13 升到了 0.38。现在每个带键的随机数流都以用途开头、以 1 结尾,有测试检查同一种子下的各个流互不相关,重新运行模拟器构建也逐位复现了已提交的输入。