seqrec-lab
对 Transformer 序列推荐模型 SASRec、BERT4Rec 和 gSASRec 的预注册研究:各组调参预算相同,每组 5 到 10 个种子,在全部物品上排序评测,在一块租用的消费级 GPU 上进行。在 MovieLens-1M、Video_Games 和 Steam 上,用完整交叉熵训练的 SASRec 领先 BERT4Rec 和 gSASRec,用 BCE 加一个负样本训练的 SASRec 比它低 2% 以上。MovieLens-1M 的测试目标在正式运行之前已被锚点检查读过。MovieLens-20M 还没有结果。
关键指标
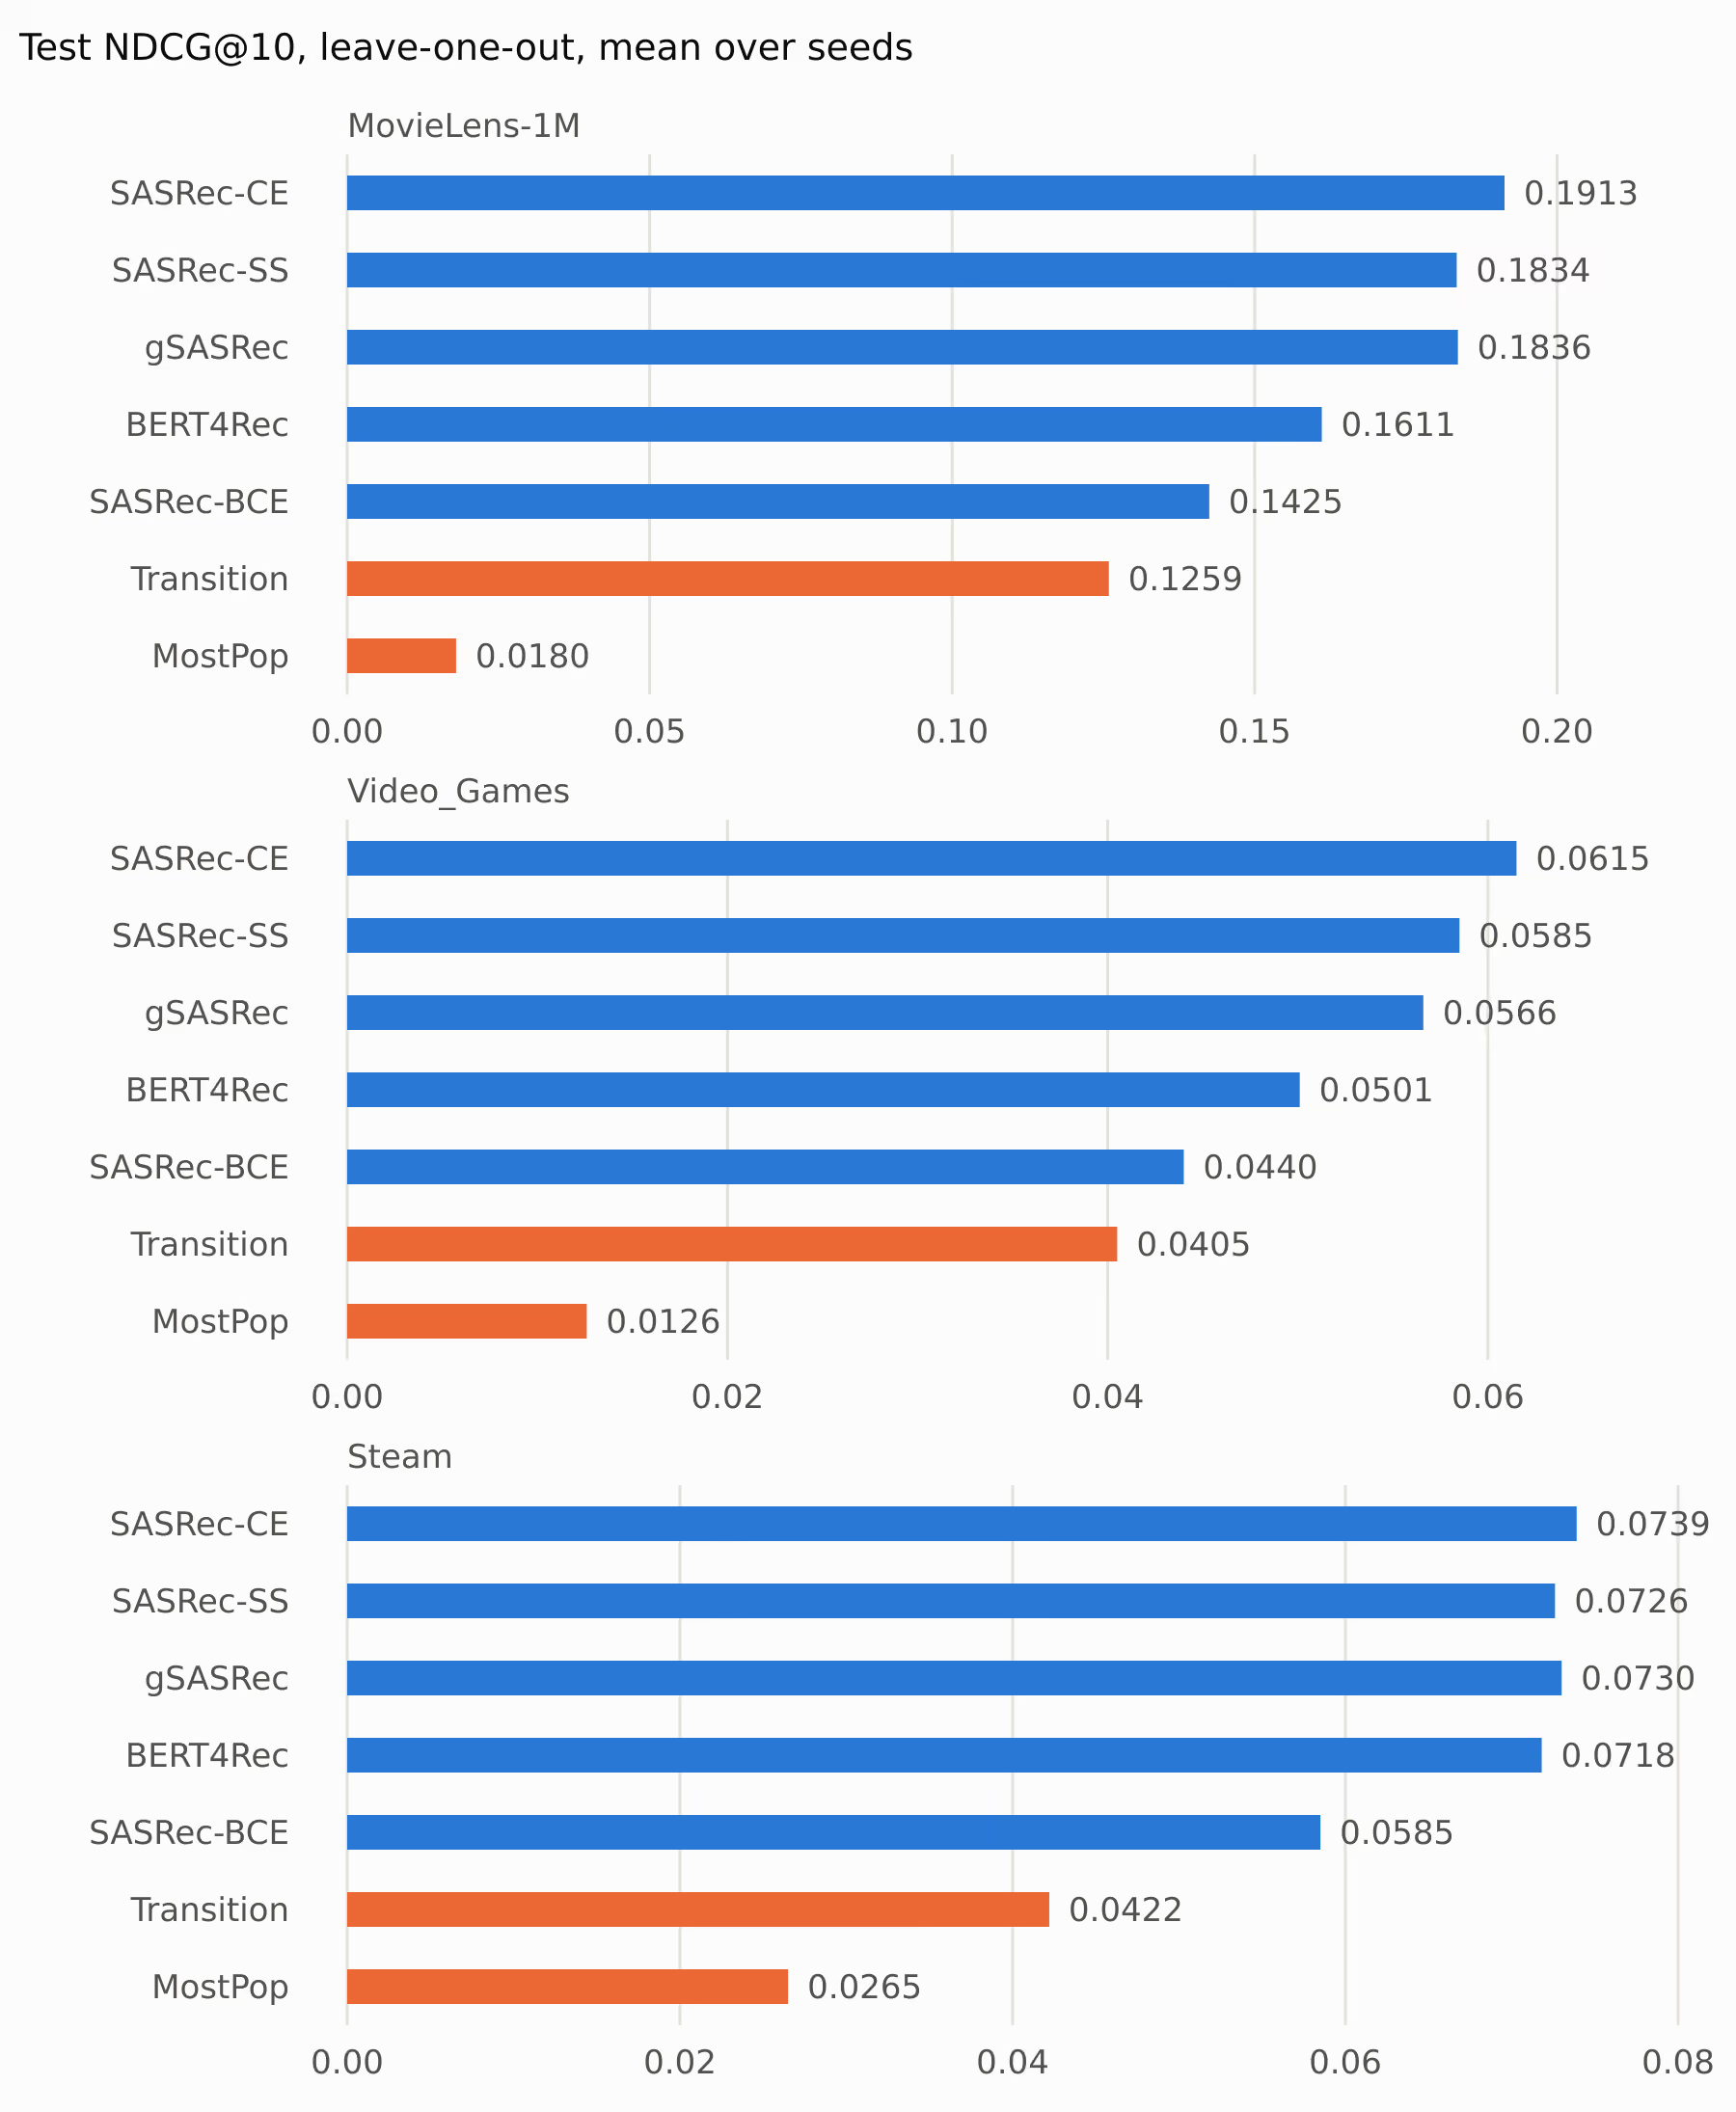
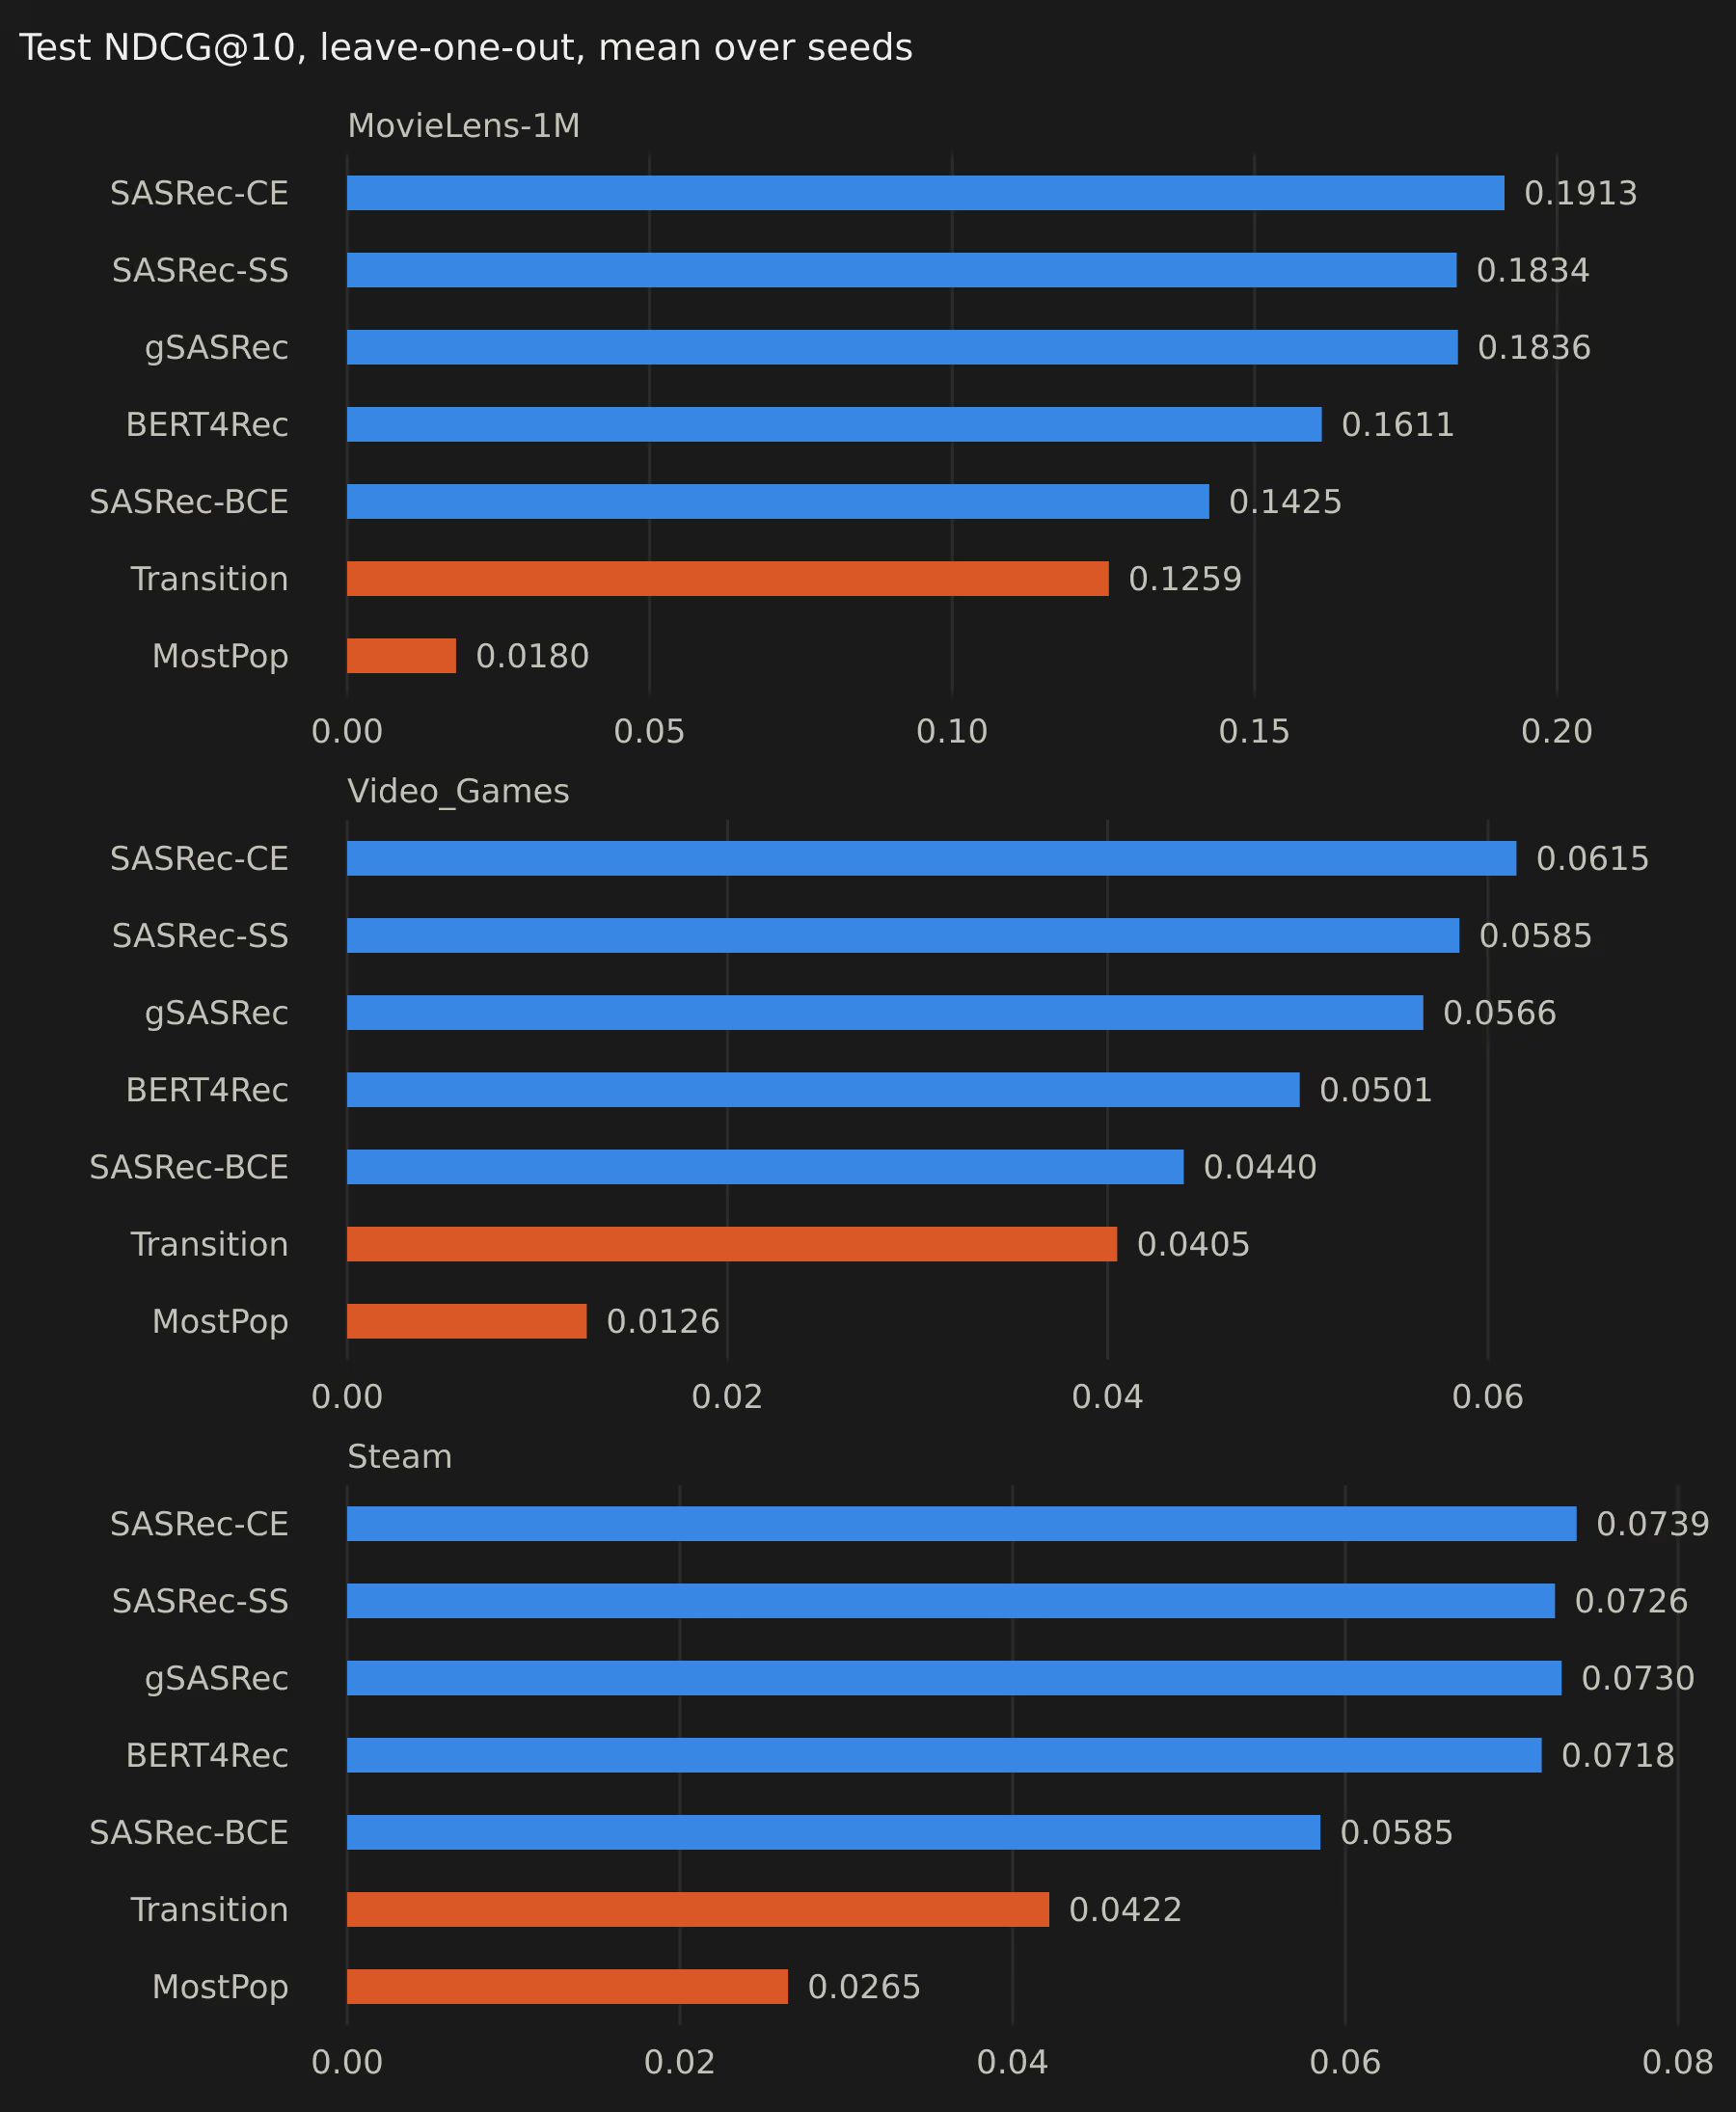
- 用完整交叉熵训练的 SASRec 相对用 BCE 加一个负样本训练的 SASRec,在 MovieLens-1M、Video_Games 和 Steam 上测试 NDCG@10 的提升。三处的最小效应检验都显示差距超过 2%
- +34.3%、+39.7%、+26.5%
- 同样三个数据集上,用完整交叉熵训练的 SASRec 相对 BERT4Rec 的提升。在 MovieLens-1M 上,它证实了已发表的差距,也表明 SASRec 不劣于 BERT4Rec(H1a);在 Steam 上,它的符号与已发表的差距相反
- +19.5%、+22.8%、+2.9%
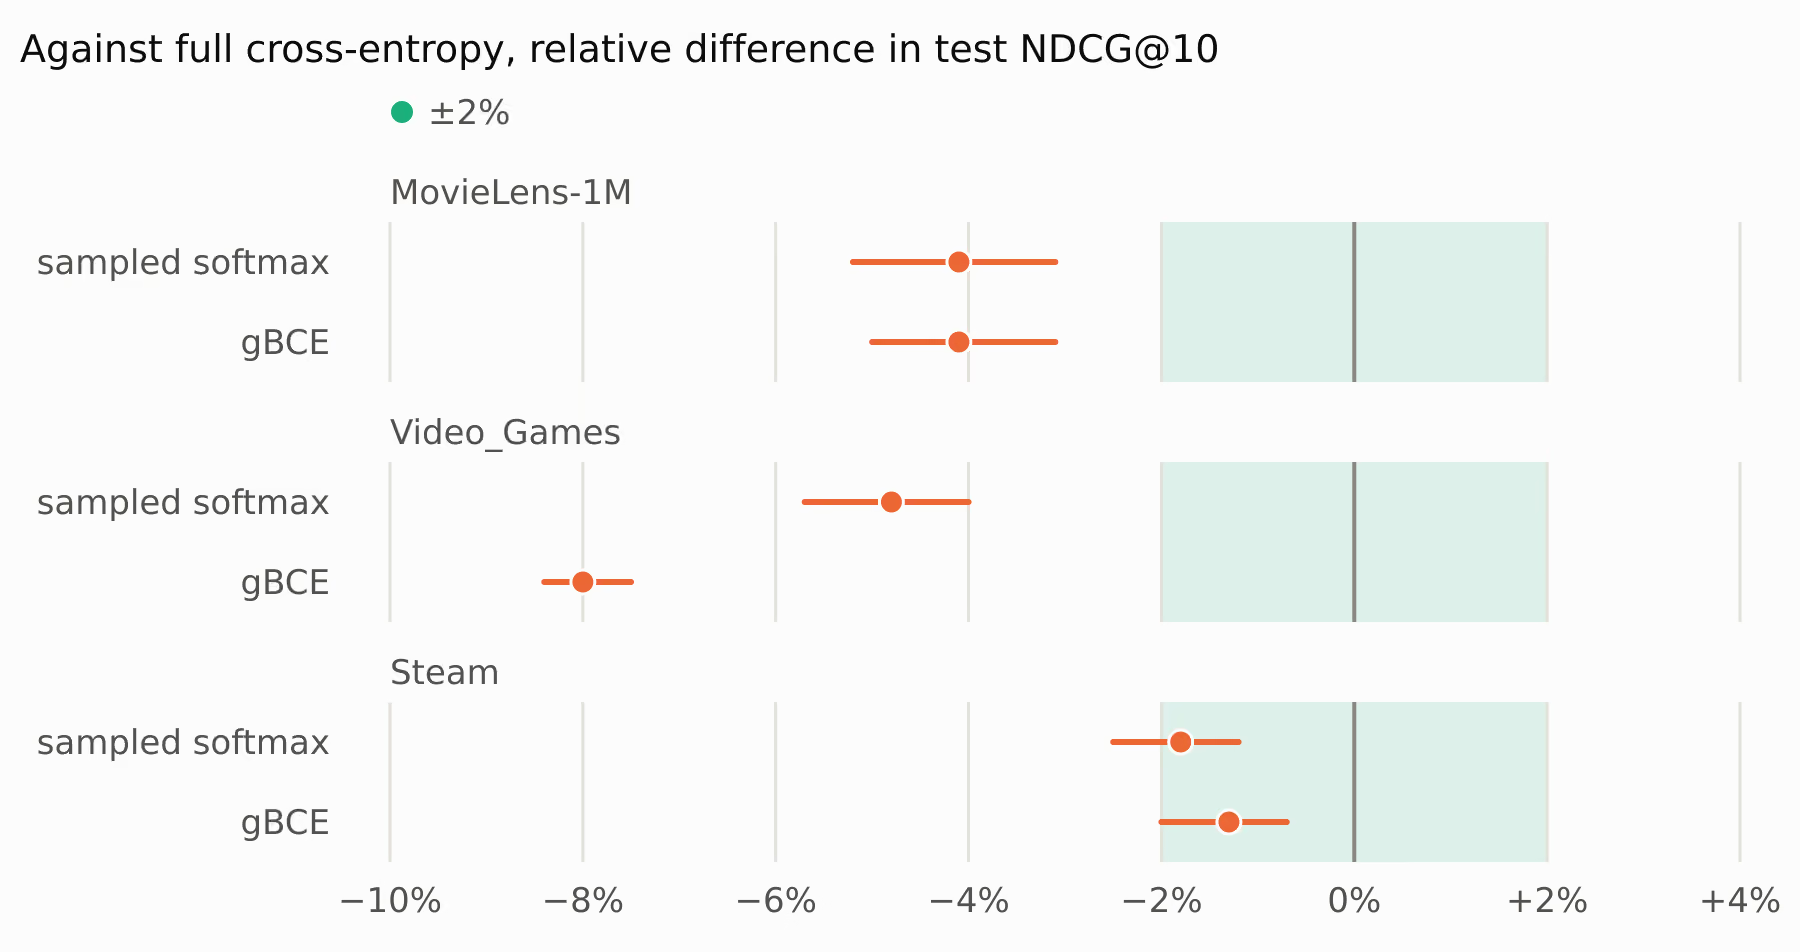
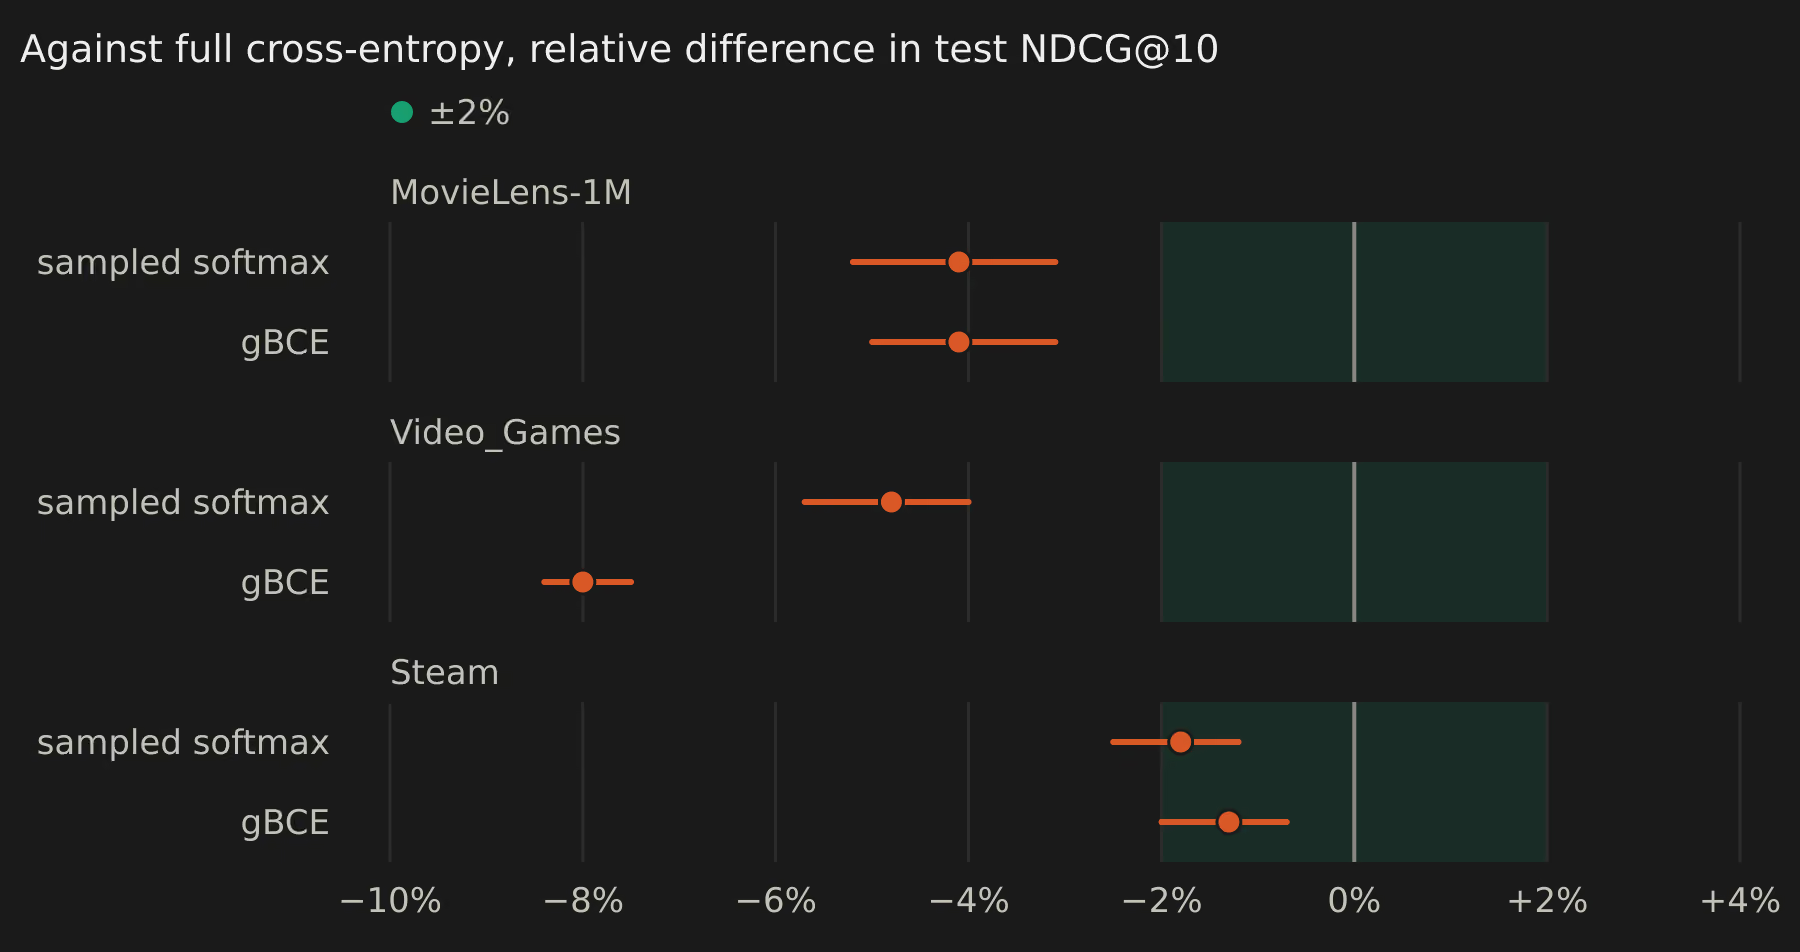
- 同一主干上 sampled softmax 和 gBCE 相对完整交叉熵的差,共三个数据集。三个数据集上都没能证明它们在 2% 以内等价(H2b)。MovieLens-1M 和 Video_Games 上所有 95% 区间都在 −2% 以下,Steam 上的差是 −1.8% 和 −1.3%
- −1.3% 到 −8.0%
- 正式运行的次数,每次只读一次测试数据,在 RTX 4090 上共用 81.9 GPU 小时;300 次调参运行一次也没读
- 223
差值是各种子 log 测试 NDCG@10 均值之差,换算成相对差,区间是 95% Welch 区间;留一法,MovieLens-1M 每组 10 个种子,Video_Games 每组 6 个,Steam 每组 5 个。Holm 校正按每个检验族在四个数据集上登记的总数计算,所以剩下的数据集还可能改变的比较记为待定,待定的都不作为结果报告。MovieLens-1M 上一个 BERT4Rec 种子决定了种子方差,所以那里的方向性和等价性比较都标为功效不足;在这批运行之前,锚点检查还给其中四个组各读过两次它的测试目标。MovieLens-20M 还没有结果。 结果
问题与目标
曾有研究报告 BERT4Rec 胜过 SASRec。后来的工作把这个差距的大部分归因于 SASRec 的训练目标(只用一个采样负样本的二元交叉熵)和训练时长,并发现用完整交叉熵训练的 SASRec 在多数数据集上领先。这些研究大多只报告单次训练、调参预算不等或没有说明,并采用留一法划分;而 SASRec 不同运行之间 1% 到 2% 的差别,换个种子就可能分出不同的胜者。
seqrec-lab 用纯 PyTorch 重新实现 SASRec、BERT4Rec 和 gSASRec,在四个数据集上比较五个组:分别用 BCE、完整交叉熵、sampled softmax 和 gBCE 训练的 SASRec,以及 BERT4Rec,另有两个下限基线。各组调参预算相同,在全部物品上排序,种子数按功效规则决定。研究要回答:已发表的差距有哪些站得住,每种训练目标达到目标质量要花多少时间。假设、检验和 2% 的最小关注效应在任何模型用真实数据训练之前就冻结了。
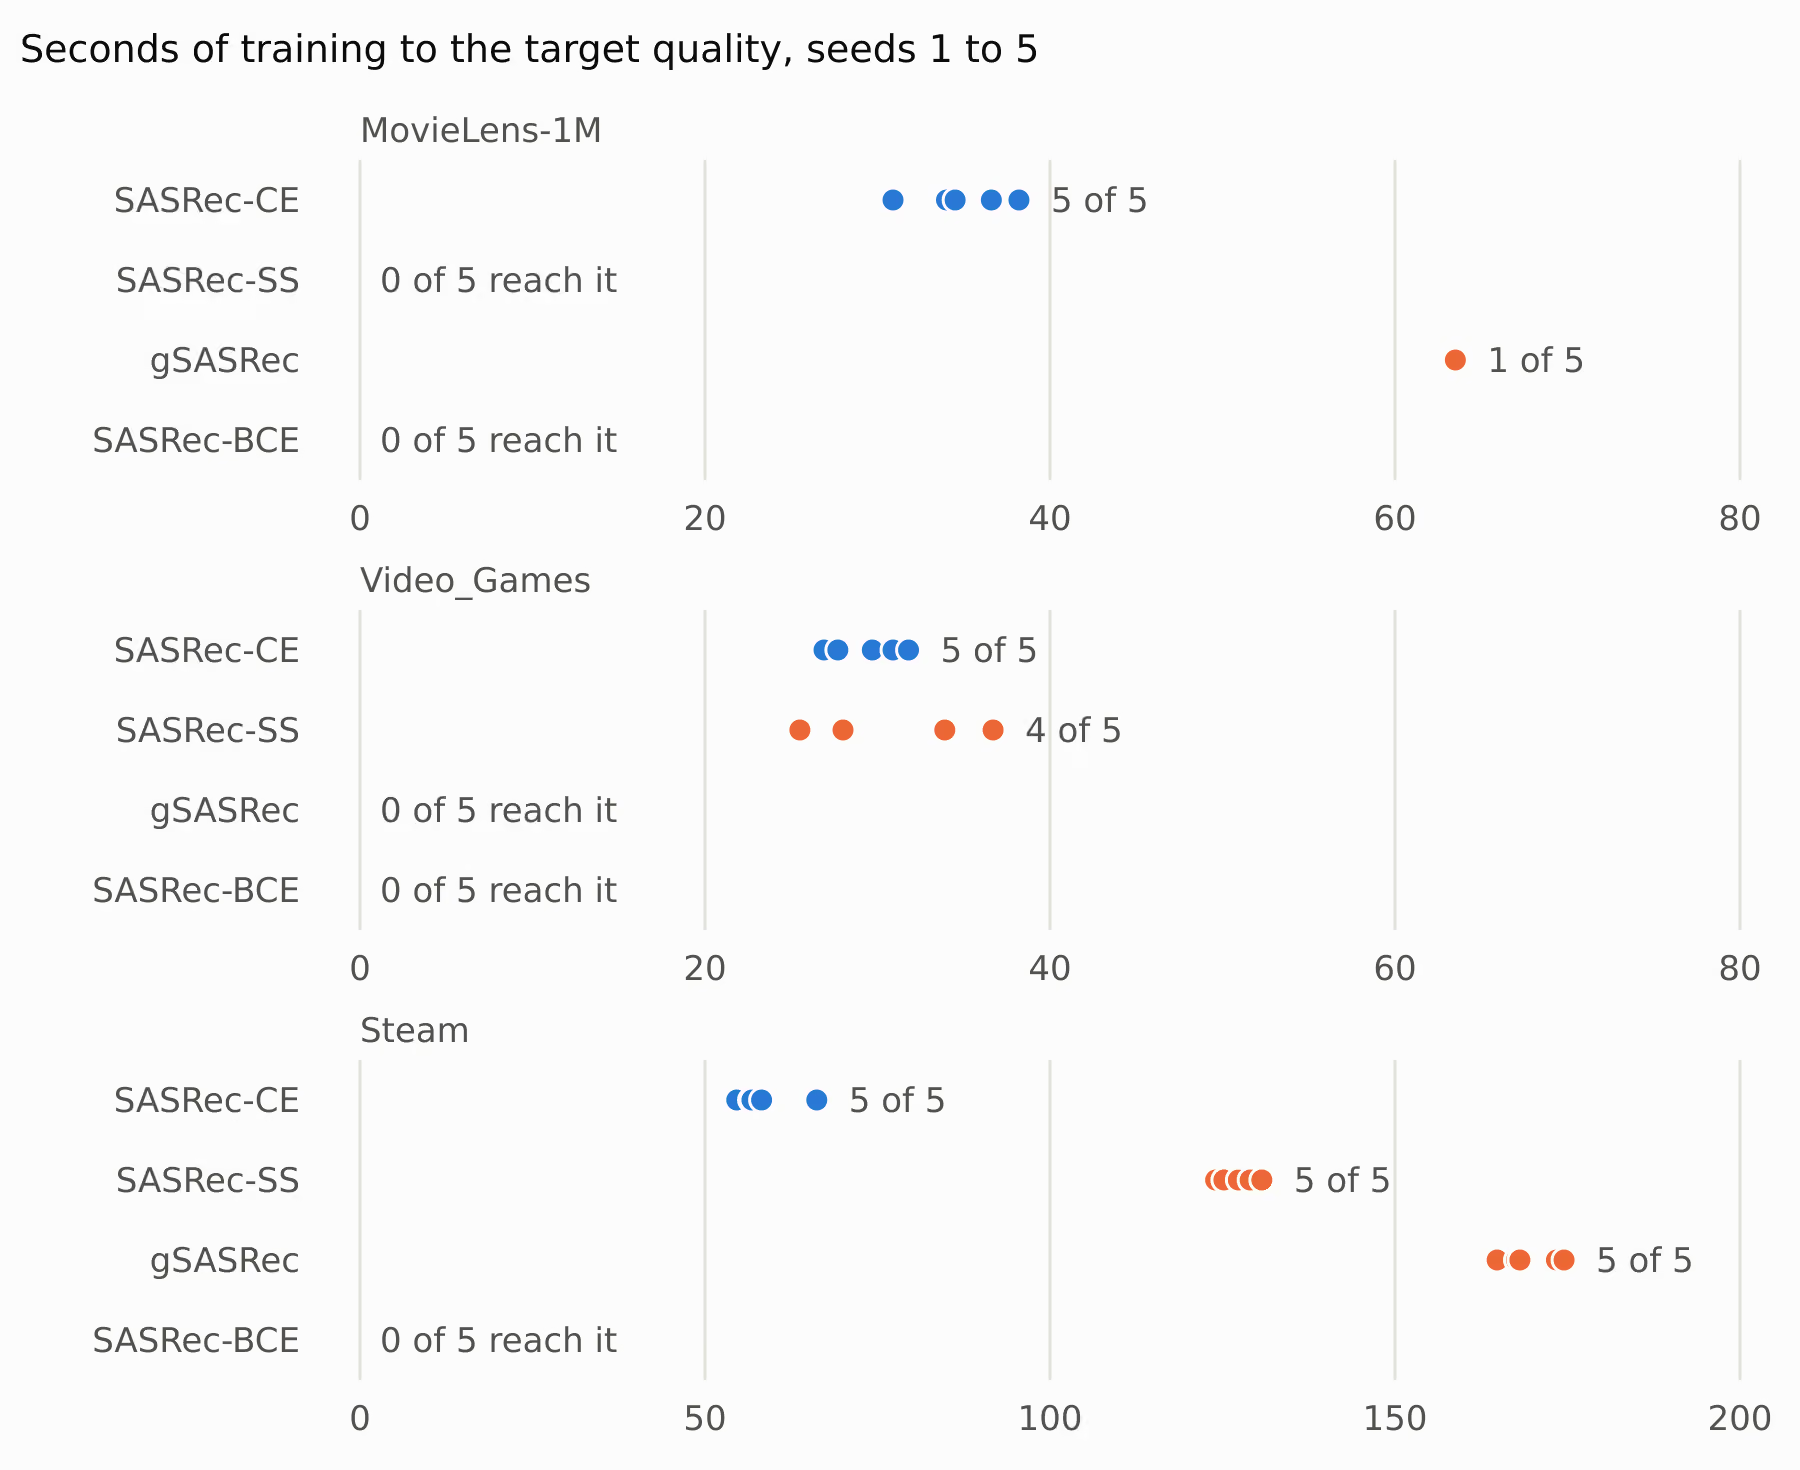
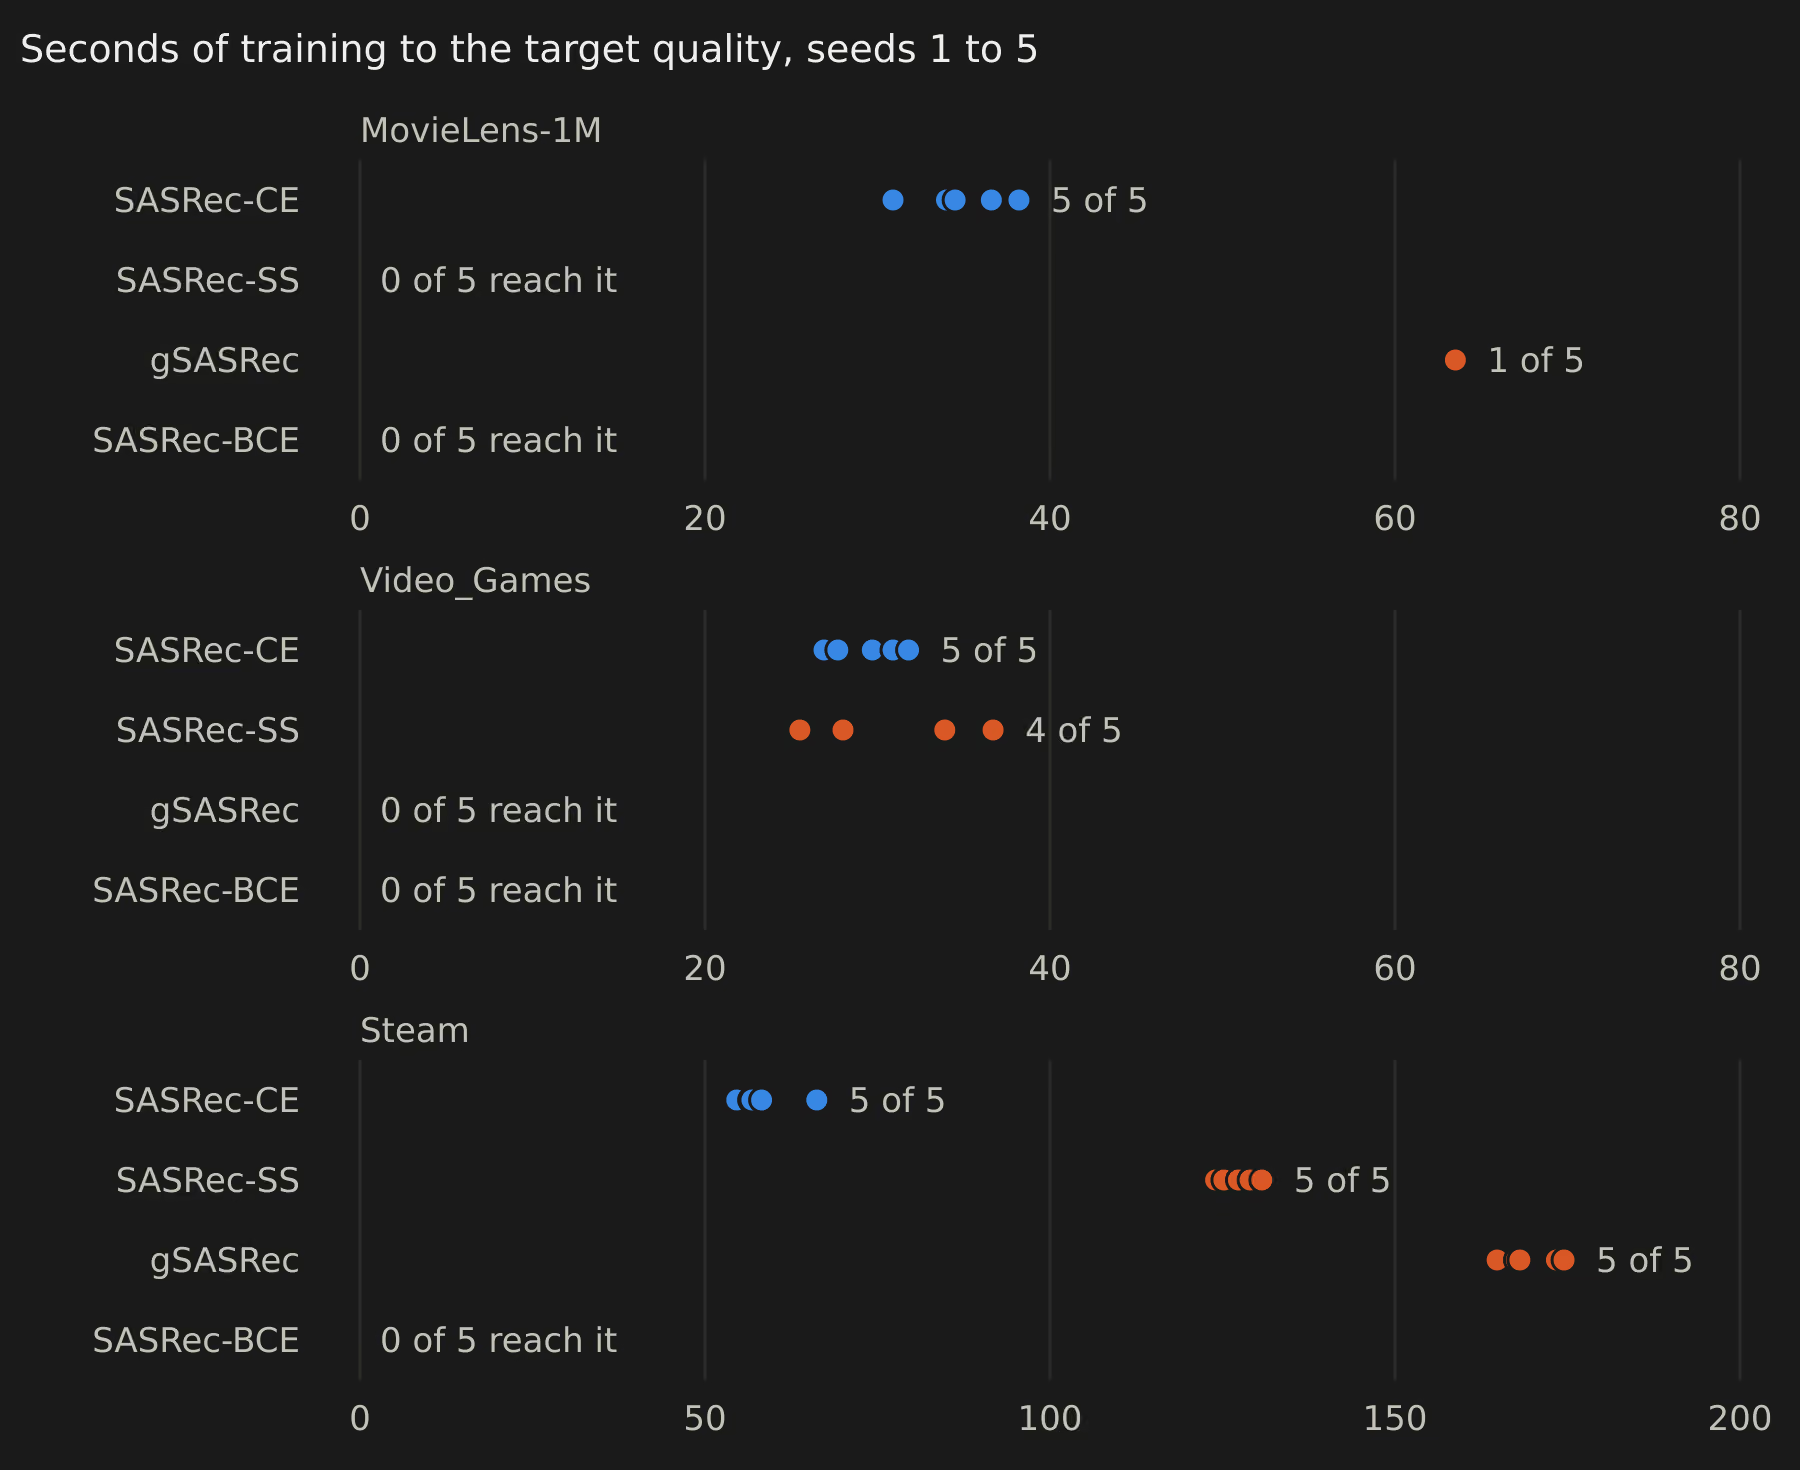
在已有结果的三个数据集上,H1a(用完整交叉熵训练的 SASRec 不劣于 BERT4Rec)在 MovieLens-1M 上成立,它只在两个 MovieLens 数据集上登记。H1b(用 BCE 训练的 SASRec 比其余三组都低 2% 以上)在 Video_Games 和 Steam 上成立,在 MovieLens-1M 上待定,那里与 BERT4Rec 的检验要等 MovieLens-20M。H2a(完整交叉熵最先达到目标质量)在 MovieLens-1M 和 Steam 上成立,在 Video_Games 上不成立,那里 sampled softmax 和它分不出先后。H2b 中关于 BCE 的部分在三个数据集上都成立,预期 sampled softmax 和 gBCE 与完整交叉熵等价的部分都不成立。
MovieLens-1M、Video_Games 和 Steam 已有正式运行和确认性分析。MovieLens-20M 还没有,它上面的每个比较都待定。关于训练时间花在哪里的效率研究,以及视条件而定的近似检索问题,都还没有做。
架构
seqrec data prepare 下载四个数据集,按 SHA-256 校验每个文件并做预处理,src/seqrec/data 再生成留一法和时间划分。五个组是 src/seqrec/models 里的 PyTorch 模型。每批运行都在一台 Ryzen 9 7950X 主机上的租用 RTX 4090 上进行:seqrec tune 在验证数据上为每个组和数据集各做一次 Optuna 调参,seqrec run 按功效规则给出的种子数训练正式运行。seqrec test 通过唯一一个记录每次读取的函数,为每次正式运行读一次测试数据。seqrec export 写出批次文件和读取次数,seqrec analyze 对它们执行冻结的 METHODS 里的检验,写出 docs/RESULTS.md 依据的表格。
登记的规则
-
§7 2% 的效应,在运行之间检验
分析单位是一次训练运行,以它测试 NDCG@10 的对数计分;两组之间用各自的种子做 Welch t 检验,每个检验族内做 Holm 校正。按用户做检验会过于自信,而运行之间 1% 到 2% 的差别换个种子就可能分出不同胜者,所以最小关注效应定为 2%;等价性用对 ±2% 的双单侧检验。种子数取 5 到 10 中使两类检验在 2% 处功效都达到 0.8 的最小值,都达不到时取 10,方差来自前 5 个种子:Steam 是 5 个,Video_Games 是 6 个;MovieLens-1M 是 10 个,那里都达不到。
-
§5 每组同样的调参预算
每个组在每个数据集上做一次 20 次试验的 Optuna 调参(MovieLens-20M 为 10 次),都用训练种子 0,上限事先定好:SASRec 各组最多训练 300 轮,BERT4Rec 1,000 轮,每次运行最长 8 小时。最好的一次试验再用每个种子重跑。如果按相同的墙钟时间分配预算,快的组会占便宜,质量问题也会和开销问题混在一起。某组超过 20% 的调参试验被上限截断时,它的正式运行把所有上限加倍。
-
§11 测试数据只读一次
测试划分是封存的。取分数时只有一个读取函数能打开它,调用时必须注明阶段(final 或 anchor),每次读取都记下运行、提交和检查点的哈希;调参运行一碰就会失败。导出时重新清点读取次数:223 次正式运行都只读了一次测试数据。
-
§3 打乱顺序作对照
训练和评测时都把每个用户的物品顺序打乱,序列模型应当损失 2% 以上;如果在 MovieLens 上看不到这样的下降,就要先审查顺序处理和评测,再报告其他结果。没打乱的 SASRec-CE 在 MovieLens-1M 上高出 428.2%,在 Video_Games 上高出 67.8%,在 Steam 上高出 75.4%,BERT4Rec 在 MovieLens-1M 上高出 390.4%。
局限
-
MovieLens-1M 上一个种子决定了功效
一个 BERT4Rec 种子的验证 NDCG@10 只有 0.1174,其余四个在 0.1692 到 0.1740 之间,BERT4Rec 一组就占了合并种子方差的 98.9%。按登记的规则,种子数因此取 10,方向性检验在 2% 处的功效只有 0.005,所以 MovieLens-1M 上的方向性和等价性比较都标为功效不足,种子之间非常一致的组之间的比较也一样。这次运行正常结束,留在所有分析里;每个方向性和等价性检验旁另报一个只用所比两组算出的功效,它不参与任何判定。
-
MovieLens-1M 的测试目标之前被读过
为了把其中四个组和已发表的数值对照,锚点运行在正式运行之前给这四个组各读过两次 MovieLens-1M 的测试目标,一次在笔记本上,一次在租用的机器上。四个组都落在各自的范围内,MovieLens-1M 上关于差距是否站得住的每条结论都附带这一说明。
-
时间只对一类主机成立
到达目标的时间来自 Ryzen 9 7950X 主机上的 RTX 4090。在小配置上,训练一步的时间受 kernel 启动次数限制,那里的到达时间主要反映启动开销。MovieLens-1M 上的 H2a 依赖从未达到目标的运行:其余三组的 15 次运行里有 14 次没达到。在 Steam 上,它与 SASRec-BCE 的检验依赖 5 次从未达到目标的运行。