backtest-lab
一个回测平台,用来判断一个策略是否很可能过拟合:先做参数搜索,再用滚动前推分析、清洗交叉验证、回测过拟合概率和紧缩夏普比率来评判搜出的最优参数。
关键指标
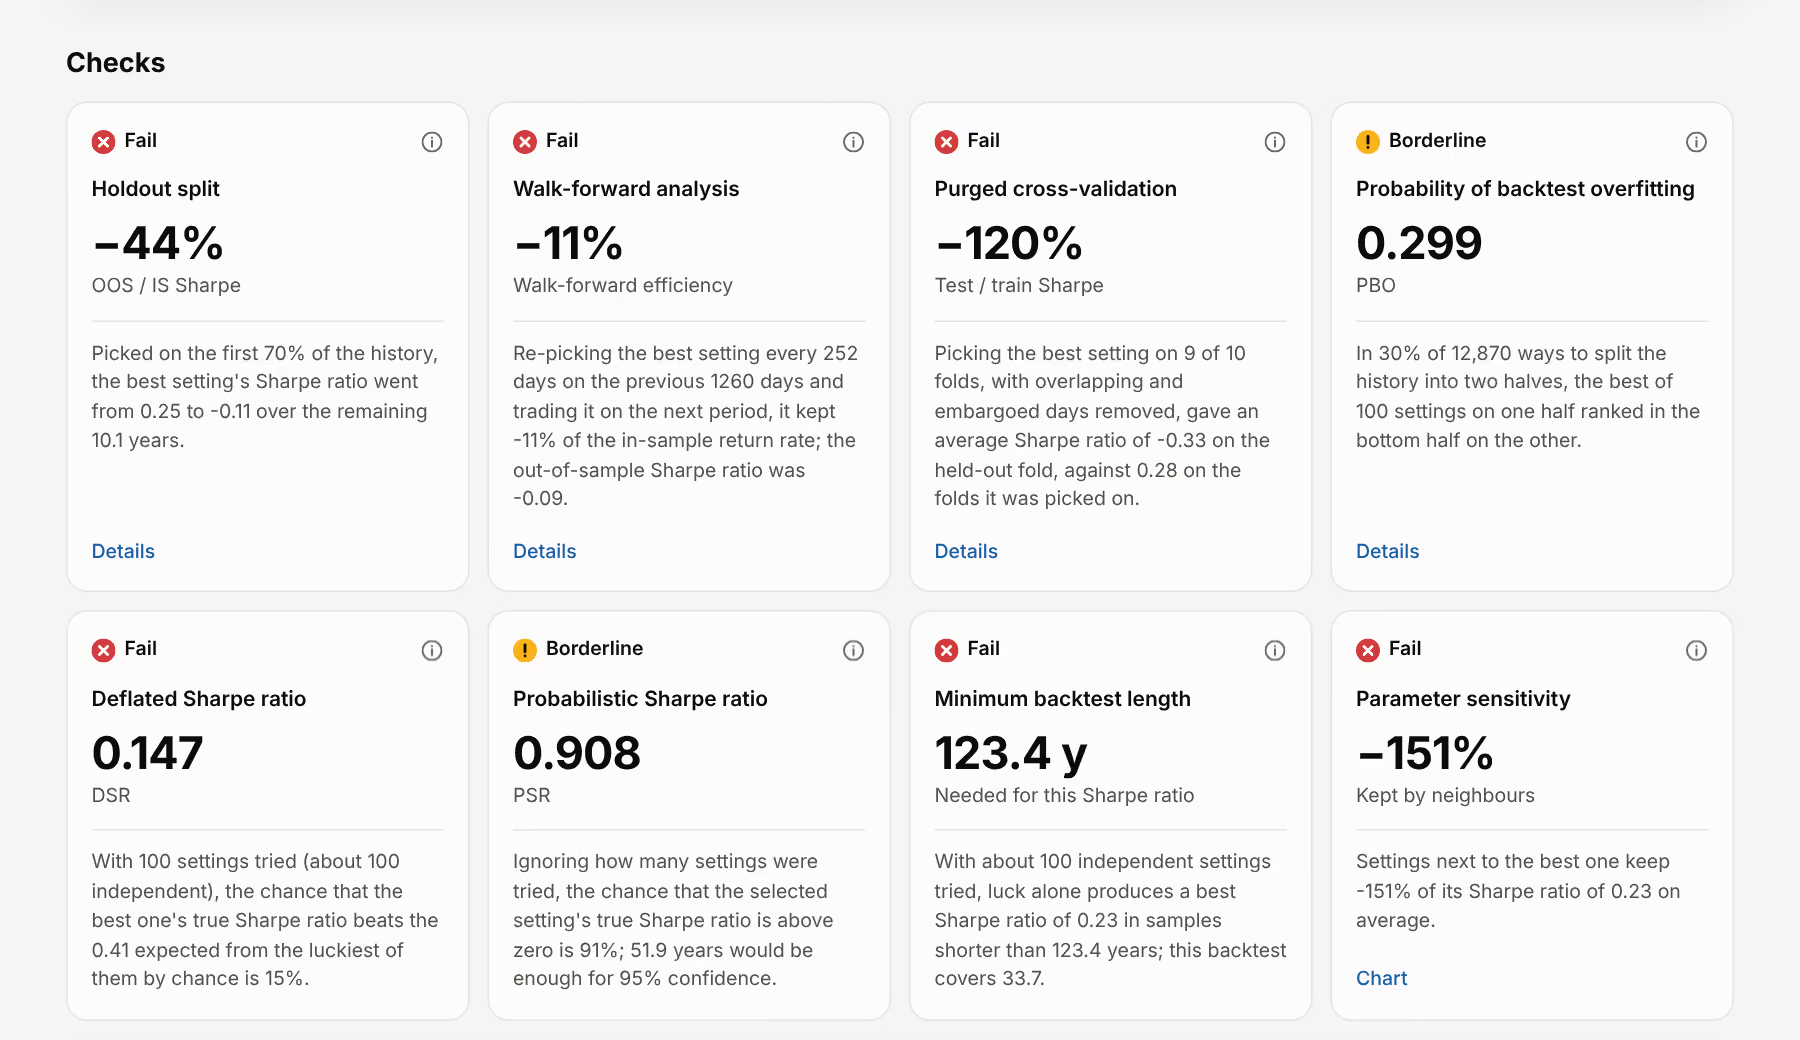
- 100 组随机信号参数中最好的一组未通过的检验项;它的夏普比率仍为正,是 0.23
- 6 / 8
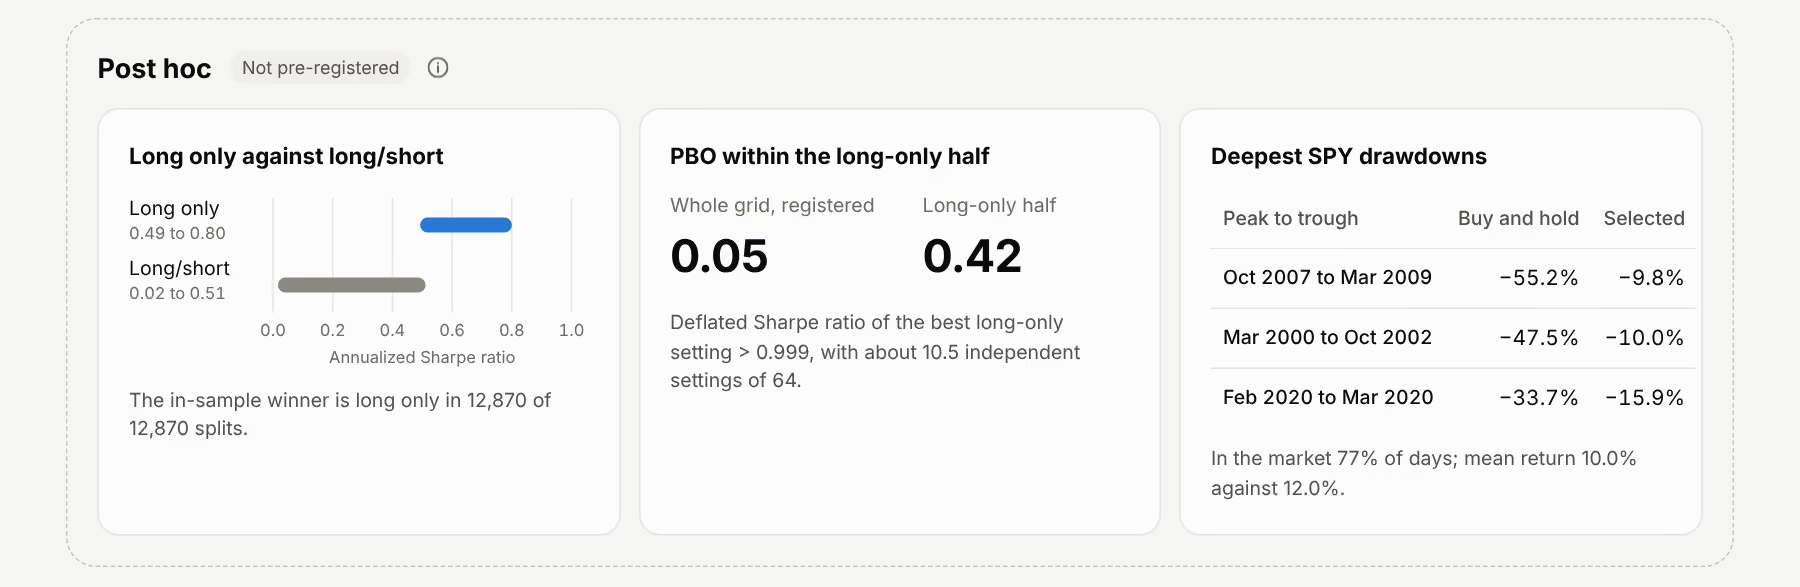
- 均线交叉搜索的回测过拟合概率,分别对应整个网格和只做多的一半(事后分析)
- 0.05 → 0.42
- 200 次模拟的无预测能力搜索中,回测过拟合概率超过红线 0.30 的比例;红线在使用任何真实数据之前就已定下
- 89.5%
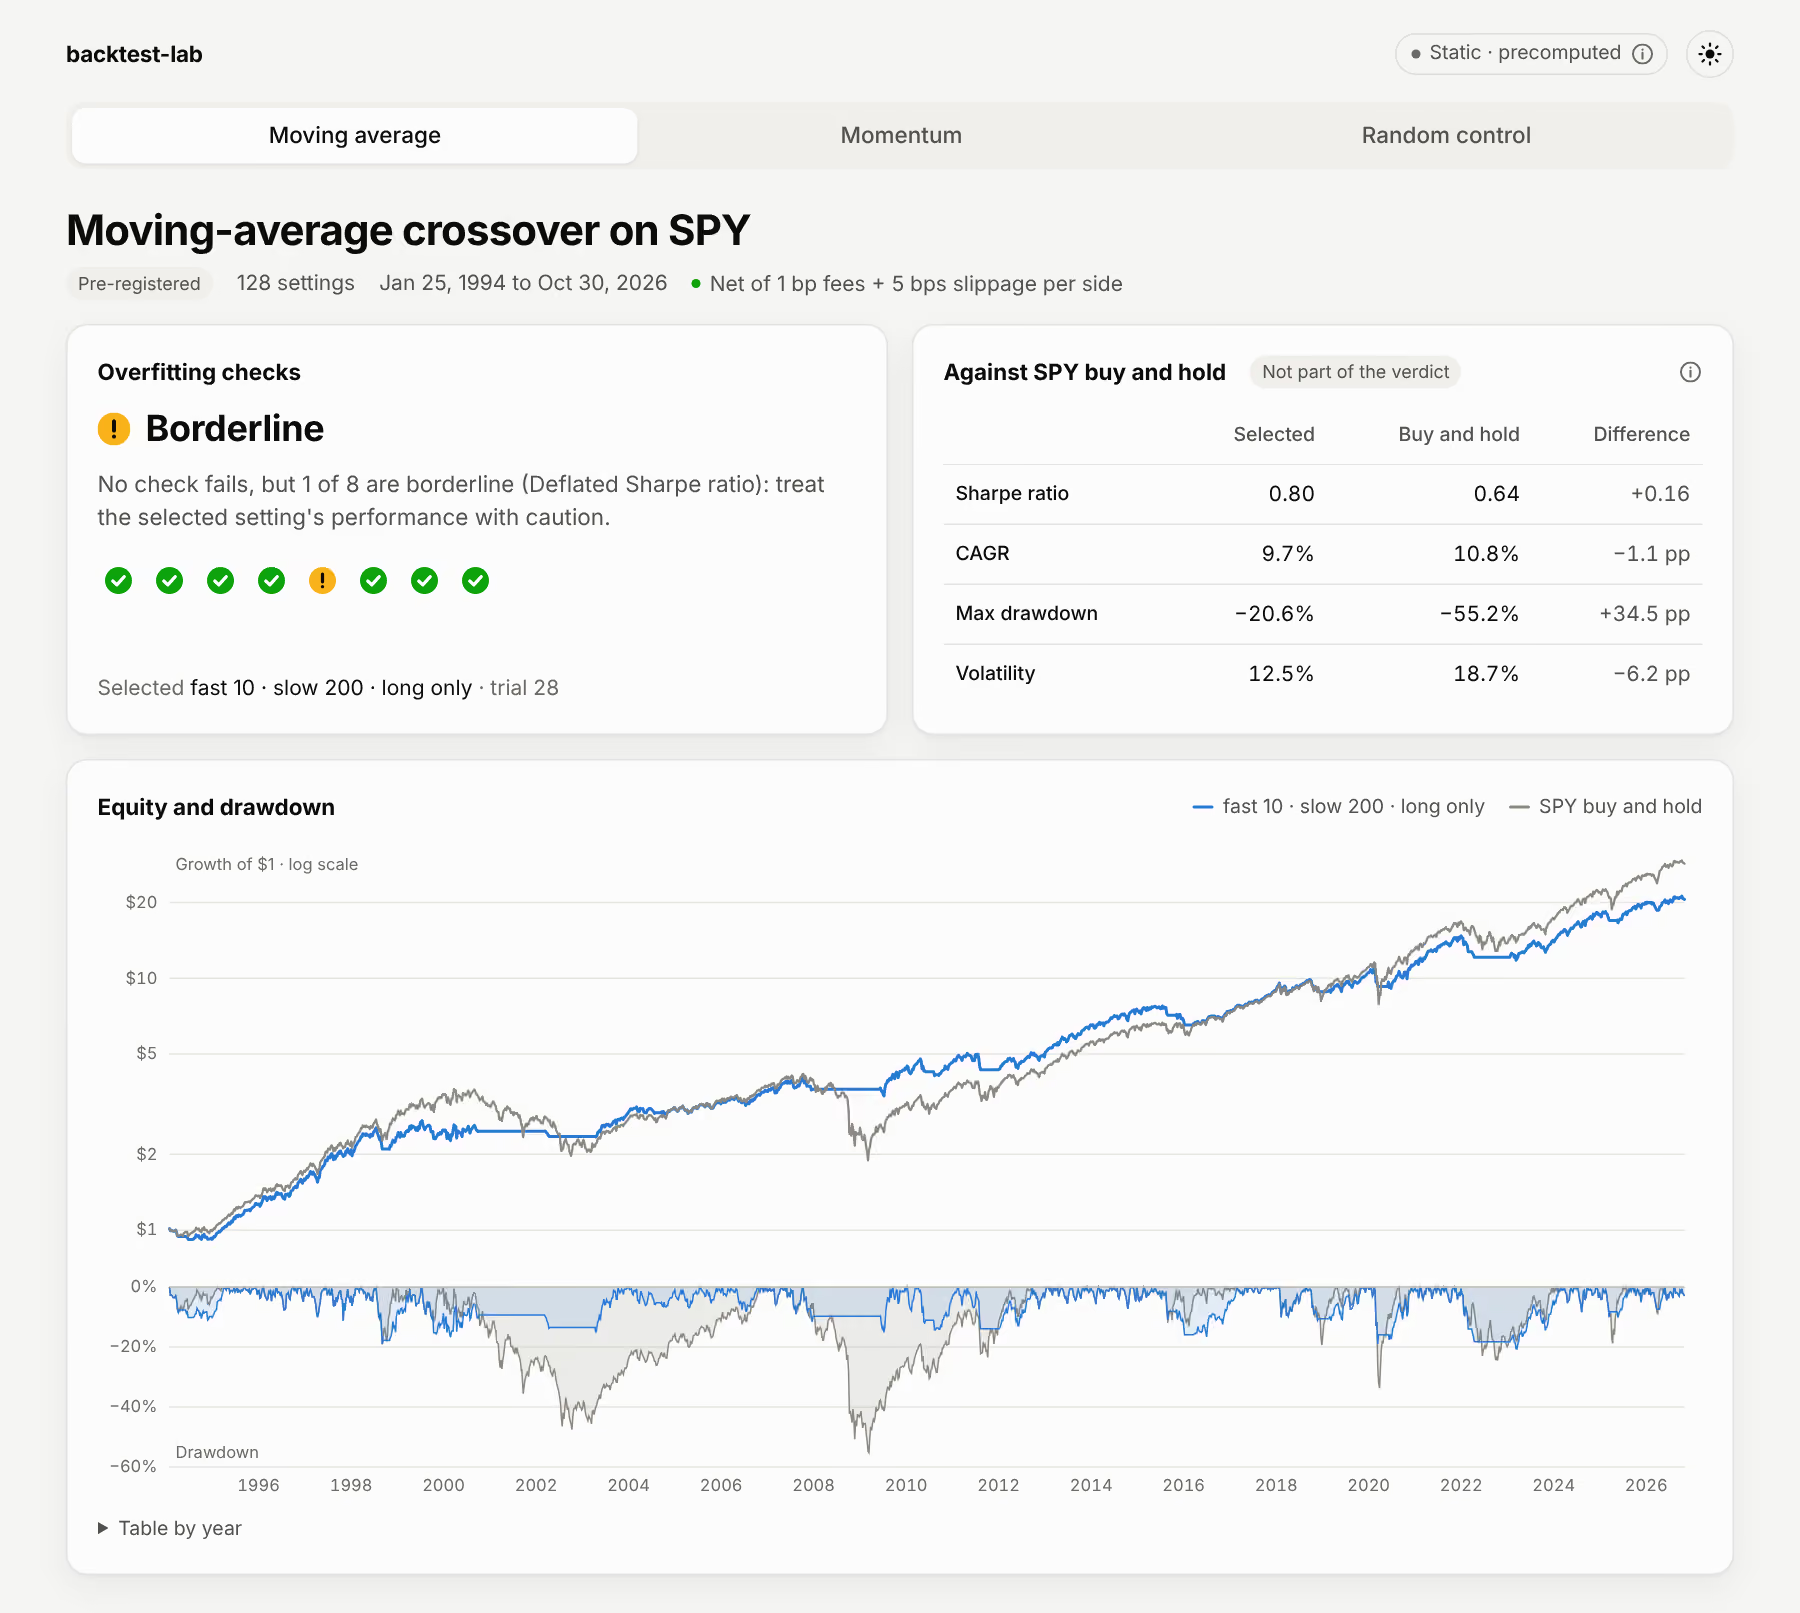
- 选中的均线参数与 SPY 买入持有各自的夏普比率;优势来自更低的波动率,12.5% 对 18.7%
- 0.80 / 0.64
三次搜索都在 SPY 1993 年 1 月到 2026 年 10 月的数据上进行,配置在任何策略接触真实数据之前就已固定,收益已扣除单边 1 个基点的费用和 5 个基点的滑点;每份报告的样本从网格里每组参数都有信号时开始,均线交叉搜索是 1994 年 1 月。事后分析的数字都单独标明,不作为确证依据。 演示结果
问题与目标
参数搜索总能找出一个最优解,哪怕所有参数都毫无预测能力。backtest-lab 跑完搜索、记下每一次试验,然后判断这个最优解是否很可能过拟合,用到的方法有滚动前推分析、清洗交叉验证、回测过拟合概率(PBO)和紧缩夏普比率,共八项检验。每项检验给出红、黄、绿三档结论和一句通俗的解释,汇总成一份可信度报告,由仪表盘展示。
规格定下的要求有:日线价格取自 yfinance,宏观数据取自 FRED,存为 Parquet、用 DuckDB 查询,配有数据质量检查,并由 GitHub Actions 每周更新;回测引擎按日频运行,支持多资产和多空,计入交易成本和滑点;网格搜索保留每一次试验,多重检验校正需要这些记录;另有一个 React 仪表盘。所有公式都先写进方法文档,然后才开始实现。
演示只交易 SPY;数据里的个股是因为今天仍然存在才被选中的,带有幸存者偏差。现金没有利息,做空不付借券费,宏观数据用的是最新修订版。动量搜索用的是简化版的时间序列动量,没有原始方法里的波动率缩放、超额收益和月度再平衡。通过这些检验,只说明所选的夏普比率大于零,且不太可能仅仅来自参数搜索。这些检验不测择时能力,也没有哪一项检验去测能否跑赢买入持有:每份报告把这项比较列为描述性数字,不计入结论。
架构
每周一次的 GitHub Actions 工作流从 yfinance 抓取价格、从 FRED 抓取宏观序列,跑完质量检查后把数据存为 Parquet,用 DuckDB 查询;原始数据从不提交进仓库。回测引擎把网格里的每组参数变成每日收益,按次日开盘成交并扣除成本;检验模块在存下的试验上做网格搜索和八项检验,写出可信度报告。三份预注册报告只生成一次,之后冻结,CI 会核对它们的 SHA-256 校验和。GitHub Pages 上的 React 仪表盘只读取仓库里提交的报告。在本机运行时,仪表盘还能把自定义搜索发给只监听 127.0.0.1 的 FastAPI 服务,由它调用同一套引擎和检验,返回同样格式的报告。
关键决策
-
D021 预注册的演示
三组演示搜索在任何策略接触真实数据之前就已固定:SPY 1993 年 1 月到 2026 年 10 月,默认交易成本;均线交叉 128 组参数,时间序列动量 34 组,随机信号对照组 100 个随机种子;每项检验的设置也同时定下。每个最优参数旁边都列出 SPY 买入持有作为参照,但它不参与任何结论:无风险利率取零,又有股权溢价,偏多头的策略光靠持有市场就可能显得显著。看到结果之后,配置没有再改。
-
D022 由零假设定下的阈值
结论阈值在用真实数据跑任何东西之前就已定下,没法反过来迁就演示结果。PBO 的红线取自毫无预测能力的搜索:200 次模拟中,PBO 平均为 0.488,89.5% 高于 0.30,所以这样的搜索大约十次里有九次判红。绿档上限 0.10,依据是原论文提到有些投资者只接受低于 1/10 的 PBO。总体结论取八项中最差的一项。后来加的一条规则是:有效独立的试验少于 10 个时,本该是绿色或黄色的 PBO 和紧缩夏普比率不给结论;这条规则是看到预注册结果之后才定的,已预注册的报告保持原结论。
-
D013 次日开盘成交
目标仓位在第 t 日收盘时决定,第 t+1 日开盘时成交。当天的收益由两段复合而成:旧仓位赚取的隔夜跳空,加上新仓位从开盘到收盘的收益,交易成本在两段之间的开盘时扣除。信号最早在 t+1 成交,与清洗交叉验证假定的一天信息区间一致。开盘价和当天收盘价用同一个复权因子调整;回溯复权会把此前所有价格乘上同一个常数,所以信号必须是价格的尺度不变函数,才不会引入前视偏差。
-
D029 事后分析单独存放
演示的结论只来自预注册结果。看到结果之后才决定做的分析,比如每个网格里只做多的一半、交叉验证各次切分中的样本内最优参数、与买入持有在最深几次回撤中的对比,都放在单独的模块和结果目录里,出现在任何地方都标注为事后分析。看过结果再挑选展示哪一部分,本身就是一种选择,而这正是这个项目要度量的效应。
-
D030 用 d3-scale 和 d3-shape 画图
仪表盘的四类图表都是小型 React 组件,用 d3-scale 和 d3-shape 画 SVG,颜色取自 CSS 变量,明暗两套主题共用一份样式表。以一张最简折线图打包后 gzip 的体积来比较:按需引入的 ECharts 6 为 176 kB,Recharts 3 为 71 kB,visx 为 45 kB,uPlot 为 23 kB 但没有热力图,d3-scale 加 d3-shape 只有 16 kB。每张图都能用键盘聚焦,有可朗读的数值说明,旁边还配有数据表。
难点与解法
-
悄无声息空仓的参数搜索
通过 API 发起的参数搜索,除了交易标的的日期,还保留了基准的日期。交易标的一旦缺一根 K 线,那一行就成了 NaN,之后每个滚动指标都会在整整一个窗口内保持 NaN,策略于是空仓长达
slow或lookback天,却不报任何错误,搜索结果也和同样参数的单次回测对不上。现在搜索只用交易标的有价格的日期,基准只是这些日期上的一列;基准在其中某天缺数据时,搜索直接失败,并给出引擎的报错信息。预注册演示的交易标的和基准都是 SPY,不受影响。 -
价格数据里的陈旧开盘价
1993 年到 2026 年 10 月的 8,497 根 SPY 日线中,有 159 根的开盘价等于前一天的收盘价。在 2016 和 2017 年,这类开盘价有 21.7% 同时等于当天的最高价或最低价,其他交易日只有 0.4%,说明数据很可能是陈旧的;开盘价一旦陈旧,按次日开盘成交实际上就变成了按产生信号的那个收盘价成交。数据检查现在会对这类 K 线发出警告,但不改动数据。把这 159 个开盘价换成按当年隔夜波动率随机抽取的值(30 个随机种子),或换成当天的最低价、最高价,均线和动量的所有结论都没有变化,对照组的总体结论在每种替换下都仍是红色。
-
PBO 的两种定义
代码在一次切分的 logit 不大于 0 时就算作过拟合,这是 Bailey 等人(2017)第 3.1 节的估计量;而他们的定义 2.2 只计入低于 N/2 的排名。参数组数 N 为偶数时,两者在排名 N/2 上也有差别,估计量会把它算进去;方法文档原先说两者只在 logit 等于 0 时不同,这只对奇数组成立。按定义 2.2,三组预注册搜索在 12,870 次切分中分别有 585、1,393 和 3,748 次过拟合,而不是 607、1,590 和 3,853,对应 PBO 为 0.045、0.108 和 0.291,所有结论都不变,所以预注册报告保留原来的估计量。