retrieval-lab
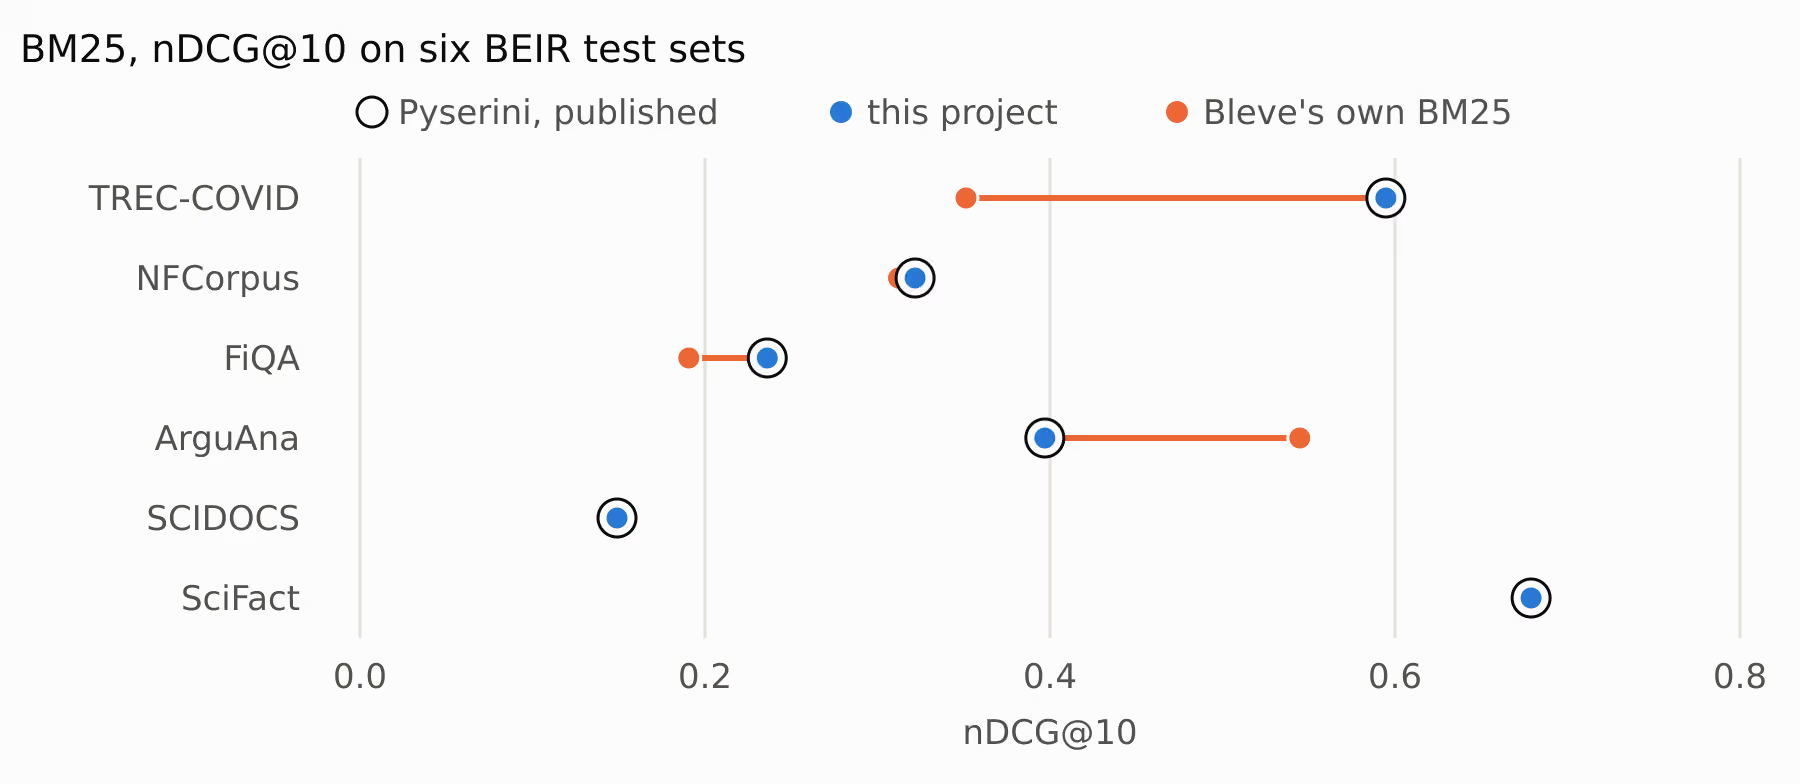
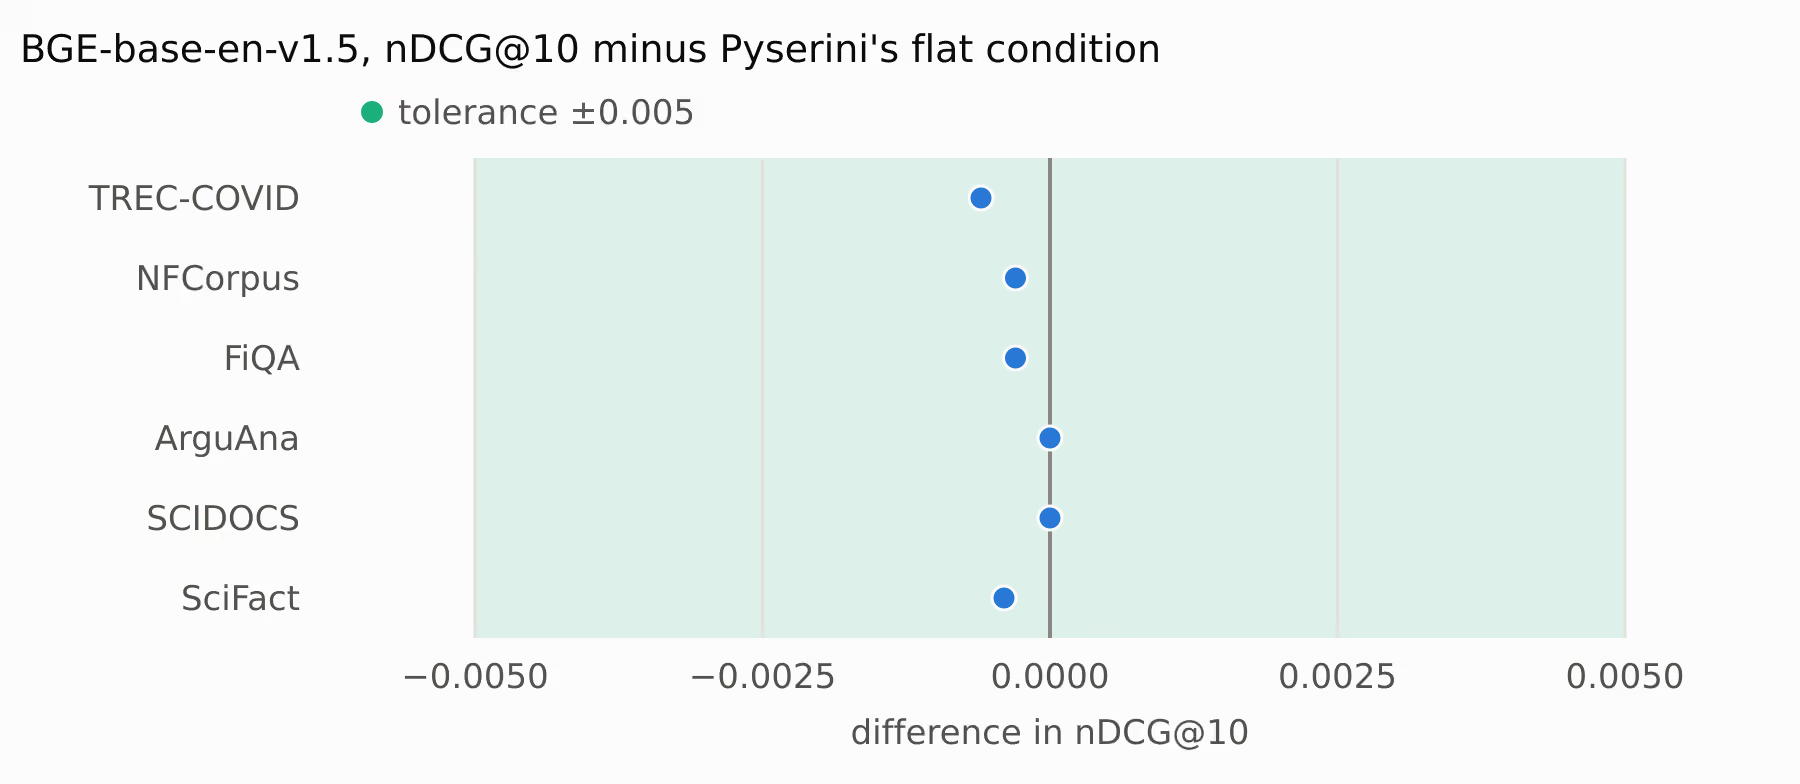
用 Go 实现的 BM25 和稠密检索,其中 BM25、用精确搜索的稠密检索和融合各自对照 Pyserini 为 BEIR 公布的数字验收。BM25 在六个数据集上的 nDCG@10 和 Recall@100 与公布值四位小数相同。BGE-base 加精确搜索在六个数据集上的 nDCG@10 相差都不超过 0.0006,除 TREC-COVID 外不超过 0.0004。在此基础上的一项预注册研究发现:ef 相同时,HNSW 造成的 nDCG@10 损失随模型而变;每个模型都搜索到相同的近邻召回率 0.95 时,就不再随模型而变。
关键指标
- BM25 的 nDCG@10 和 Recall@100 与 Pyserini 公布值四位小数相同的 BEIR 测试集数。六份 run 文件可以按已提交的 SHA-256 逐字节复现
- 6 / 6
- Bleve 自带的 BM25 打分器在 k1 和 b 相同时,nDCG@10 与同一组锚点的差。每次建索引得到的排序结果不保证相同
- −0.243 到 +0.148
- BGE-base-en-v1.5 加精确搜索与 Pyserini 的 flat 条件在六个数据集上 nDCG@10 的最大差距,出现在 TREC-COVID 上。其余五个数据集上不超过 0.0004
- 0.0006
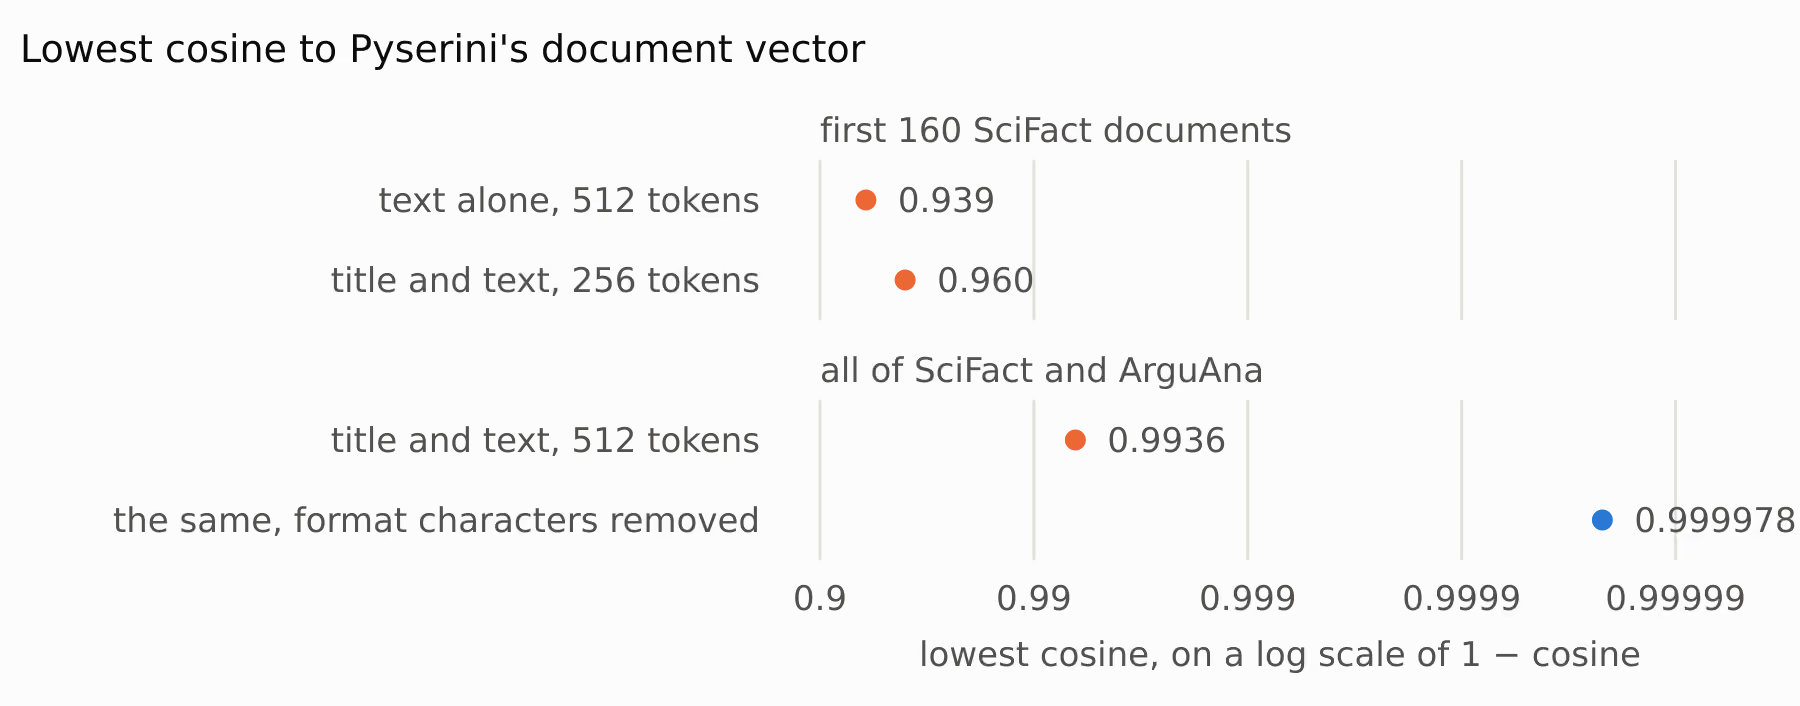
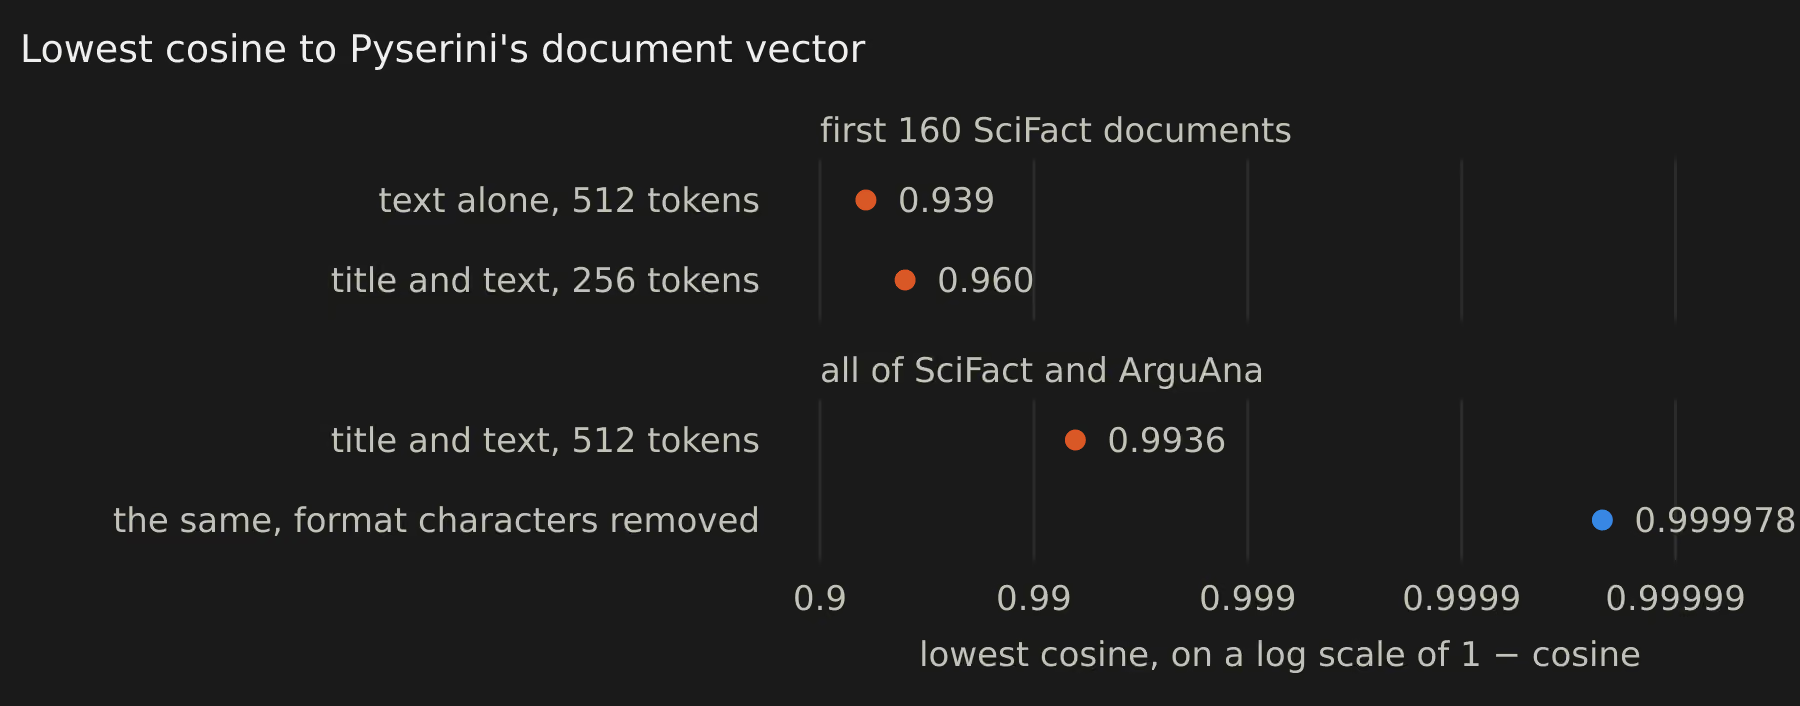
- SciFact 和 ArguAna 里文档向量与 Pyserini 的余弦低于 0.9999 的篇数,最低 0.9936。每一篇都含有 Unicode 格式字符;去掉这些字符后,一篇也没有
- 28
锚点是 Pyserini 的 beir.yaml 在某一个提交上的四位小数值,融合的锚点是同一提交上它的 BEIR 融合页面的数字。nDCG@10 的容差 0.005,对 BM25 是在任何 BM25 结果出来之前定下的,对 BGE 是和第一批 BGE 结果一起提交的。BM25 的校验和在 amd64 上成立。BGE、HNSW 和融合的数字来自一台机器;向量的末几位取决于 CPU,换一台机器具体数值可能不同。Pyserini 自己的 run 文件没有逐行比过。近似搜索用 recserve 的 HNSW 图,向量相同:在 ef 为 200、400 和 800 时,每个数据集上 HNSW 的前 10 名平均至少包含精确前 10 名中的 0.9912。融合按 Pyserini 的做法把 BM25 和 BGE 的 run 合起来,用 RRF 和 min-max 归一化后相加(Normalize)两种方法,六个数据集上的 nDCG@10 与 Pyserini 公布的融合结果相差都在 0.005 以内;差得最多的是 ArguAna,分别高 0.0036 和 0.0043。和单独的 BGE run 相比,两种融合在任何数据集上的 95% bootstrap 区间都不在零以上;RRF 在 FiQA、ArguAna 和 SCIDOCS 上、Normalize 在 ArguAna 和 SCIDOCS 上,区间整体在零以下。重排还没有做。 基准测试
问题与目标
同一套 BM25 配置的两个实现,在分词和词干提取的细节上仍然会有差别,在停用词、标题和正文怎么拼接、文档长度怎么编码、同分的结果怎么排序上也可能不同。
这个项目用 Go 实现检索的各个组件。BM25、用精确搜索的稠密检索和融合各自对照一个已公布的数字验收,第三方用公开的命令和数据就能复现:文档数少于 20 万的 BEIR 测试集,以及 Pyserini 的 BEIR 复现页面上的数字,融合用的是它的 BEIR 融合页面上的数字。超出容差的数据集不朝着锚点去调,要找到原因并记录下来。HNSW 对照同一批向量上的精确搜索来度量,不设通过阈值。
目前做完的有:评测台、BM25,用精确搜索和用 recserve 的 HNSW 图做的稠密检索,以及 BM25 与 BGE 两路 run 的融合。交叉编码器重排还没有做。
在这套评测台上,一项预注册研究比较了 8 个嵌入模型在 7 个 BEIR 数据集上的表现,每个模型和数据集各搜索 4 张 HNSW 图。模型的损失是精确搜索的 nDCG@10 减去 HNSW 的 nDCG@10,差距小于 0.005 视为可以忽略。搜索参数相同(ef 都是 40)时,损失随模型而变(H1 成立):按数据集平均,从 0.0040 到 0.0193;登记的检验在 28 对模型中分出了 19 对,其中 8 对相差超过 0.005。每张图都用能找回精确前 10 名中 0.95 的最小 ef 搜索时,损失不再随模型而变(H2 成立):在每个模型的召回率都能对齐到 0.95(相差不超过 0.01)的 6 个数据集上,检验分不出任何一对模型,模型间极差的 90% 区间上端是 0.0047,而每个模型的损失在 0.0101 到 0.0120 之间。在这一召回率下,HNSW 保持精确搜索给出的模型顺序(H3 成立):精确搜索分得出先后的 21 对里,没有一对颠倒,有一对分不出先后。在召回率 0.95 的设置下,单是建图这一项,就让某个模型在某个数据集上的 nDCG@10 在 49 种情形中的 15 种里变动 0.005 或更多,4 次建图之间最多相差 0.0203(H4 不成立)。在 ef 为 100 时用 RRF 与 BM25 融合,消除了损失中的 0.24,95% 区间 0.16 到 0.33,不到 H5 要求的一半(不成立)。
架构
scripts/data.sh 下载六个 BEIR 数据集并按 SHA-256 校验。cmd/bm25 用 Bleve 给每篇文档的标题和正文建索引,再用 Lucene 的 BM25 公式在 Bleve 的倒排表上为测试查询排出结果。cmd/embed 用 ONNX Runtime 上的 BGE-base-en-v1.5 编码每个语料,cmd/dense 编码查询并与每个向量比较。cmd/bm25 和 cmd/dense 各自写出每个查询前 1000 名的 TREC run 文件。cmd/eval 按 trec_eval -c 的规则给 run 文件打分,scripts/check-eval.sh 把它的输出与 trec_eval v10.0 的输出按文本比较。cmd/table 从 run 文件算出指标表,把每个数字排在 Pyserini 公布的数值旁边;加上 -dense 时,它还把 SciFact、NFCorpus 和 ArguAna 每篇文档的向量与 Pyserini 预建索引里的向量比较。
关键决策
-
D004 先定锚点和容差
锚点是 Pyserini 的
beir.yaml在某一个提交上的 BM25 数值,取四位小数。容差是每个数据集 nDCG@10 相差不超过 0.005,在任何 BM25 结果出来之前定下:同一套配置的两个实现在分词和词干提取的细节上会有差别,但它对 nDCG@10 的影响应该远小于换一种方法。 -
D003 指标用 Go 实现,对照 trec_eval 检查
锚点是 trec_eval 算出的数字,所以同分怎么排、相关度等级怎么算、哪些查询计入,都按它的规则。指标用 Go 实现,trec_eval v10.0 只为检查而从源码编译:一个脚本把两者的逐查询输出按文本比较。代码在自己手里,流水线里就不必带一个 C 程序;有这项检查,代码就不会走样。
-
D005 索引用 Bleve,打分用 Lucene 的公式
Bleve 负责分析文本并保存倒排索引。分数是移植过来的 Lucene
BM25Similarity,在 Bleve 的倒排表上计算,文档长度用 Lucene 那种有损的单字节编码。在 v2.6.3 里,Bleve 自带的 BM25 与 Lucene 的至少有七处不同,其中两处:它对词频取平方根;它的平均长度由各段里不同词项的个数算出,不是由长度算出,所以段合并时会变。 -
D010 文档文本和长度,从 Pyserini 的向量上读出来
Pyserini 没有公布它预建的 BGE 索引是用什么命令编码的,它自己的编码器默认是 256 个 token。它的索引里存着文档向量,所以选择是从向量上读出来的:标题和正文用空格拼接、最多 512 个 token,在 SciFact 的前 160 篇文档上余弦都不低于 0.999999;256 个 token 时最低是 0.960。
-
D012 CI 按容差检查稠密检索的结果,不用校验和
ONNX Runtime 按 CPU 的指令集选择计算内核,所以不同机器上的向量在末几位可能不同,换一台机器校验和就会无故失败。每次推送,CI 编码 NFCorpus,只要 nDCG@10 与锚点相差超过 0.005,或者有文档向量与 Pyserini 的余弦低于 0.9999,就判失败。
难点与解法
-
Bleve 的 BM25 和 Lucene 的不一样,两次建索引的结果也不一样
k1 和 b 设成相同时,Bleve 自带的打分器在 TREC-COVID 上比锚点低 0.243,在 ArguAna 上高 0.148。同一份数据建两次索引,即使都合并成单段,它的 run 文件也不相同:结果表所用的那一对索引里,六个数据集有五个如此,重跑时 ArguAna 的 nDCG@10 分别是 0.5448 和 0.5442。原因没有查。这些运行只作参考,本项目的检索不走这条路,也不进 CI。
-
对数低了一个末位单位
对 3 和 9,Go 的
math.Log2比 C 的结果低一个末位单位,这可能改变 trec_eval 打印的第四位小数。所以第 1 到 10 名的折扣用的是 C 那边正确舍入的值。第 10 名之后的折扣仍然来自math.Log2,所以 k 大于 10 的 nDCG@k 在少数情况下可能与 trec_eval 在第四位小数上不同。 -
28 篇文档里有看不见的字符
文档的编码方式定下之后,SciFact 和 ArguAna 仍有 28 篇与 Pyserini 向量的余弦低于 0.9999,每一篇都含有软连字符、零宽空格或从左到右标记。Pyserini 的编码器用的 Hugging Face BERT 规范化器会删掉这类字符;Go 的分词库只删控制字符。现在文档在编码前先删掉 Unicode C 类的所有字符,制表符、换行和回车除外。查询保留格式字符,和锚点的查询分词器一样。
-
研究没有覆盖的
研究只涉及一种 HNSW 实现、文档数不超过 270 万的语料、英文文本和这 8 个模型。它不报告延迟:ef 相同只是搜索参数相同,并不意味着开销相同。4 次建图之间的差距会低估所有可能建图之间的差距。向量没有存档,重跑需要重新编码,建出的图和 run 在细节上会不同。BEIR 的相关性标注是稀疏的,没人标注过的文档按不相关计。