recserve
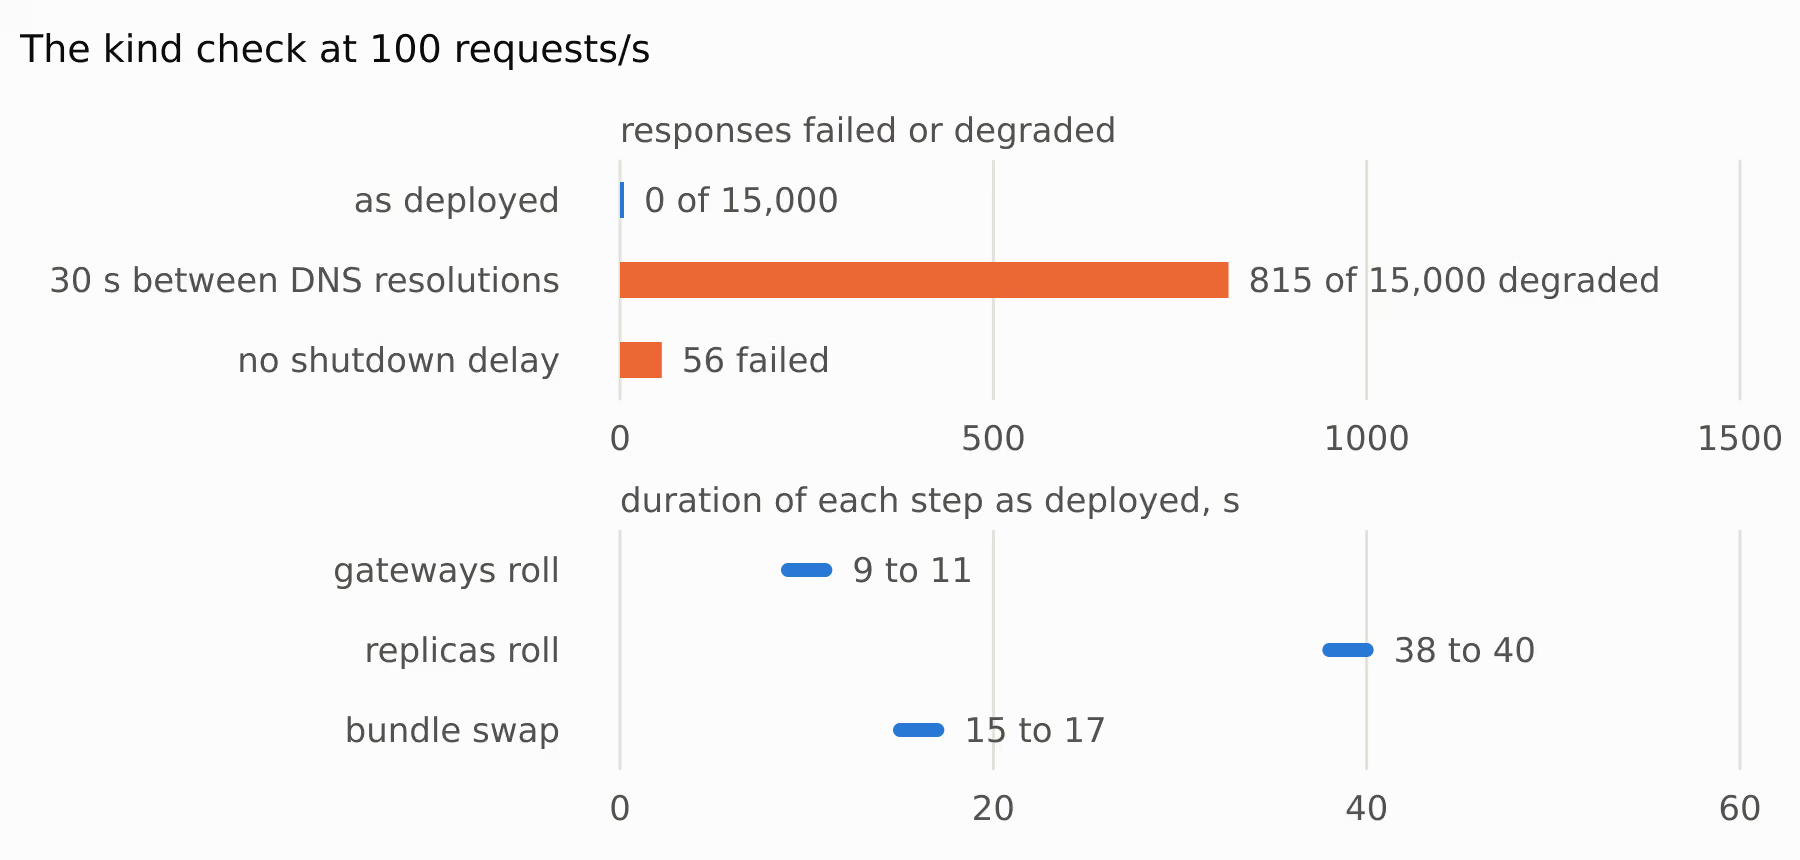
用 Go 写的推荐服务系统:召回、特征、排序和重排在同一个 HTTP 接口后面,物品向量分片放在 gRPC 副本上。在 kind 集群里每秒 100 个请求下,经过网关滚动重启、副本滚动重启和一次换包,15,000 个响应里没有一个失败或降级;各阶段的时间预算设为 100 ms。
关键指标
- kind 集群里每秒 100 个请求下,网关滚动重启、副本滚动重启和一次换包期间失败或降级的响应数。那里各阶段的时间预算是 100 ms,规格里是 5 到 15 ms
- 0 / 15,000
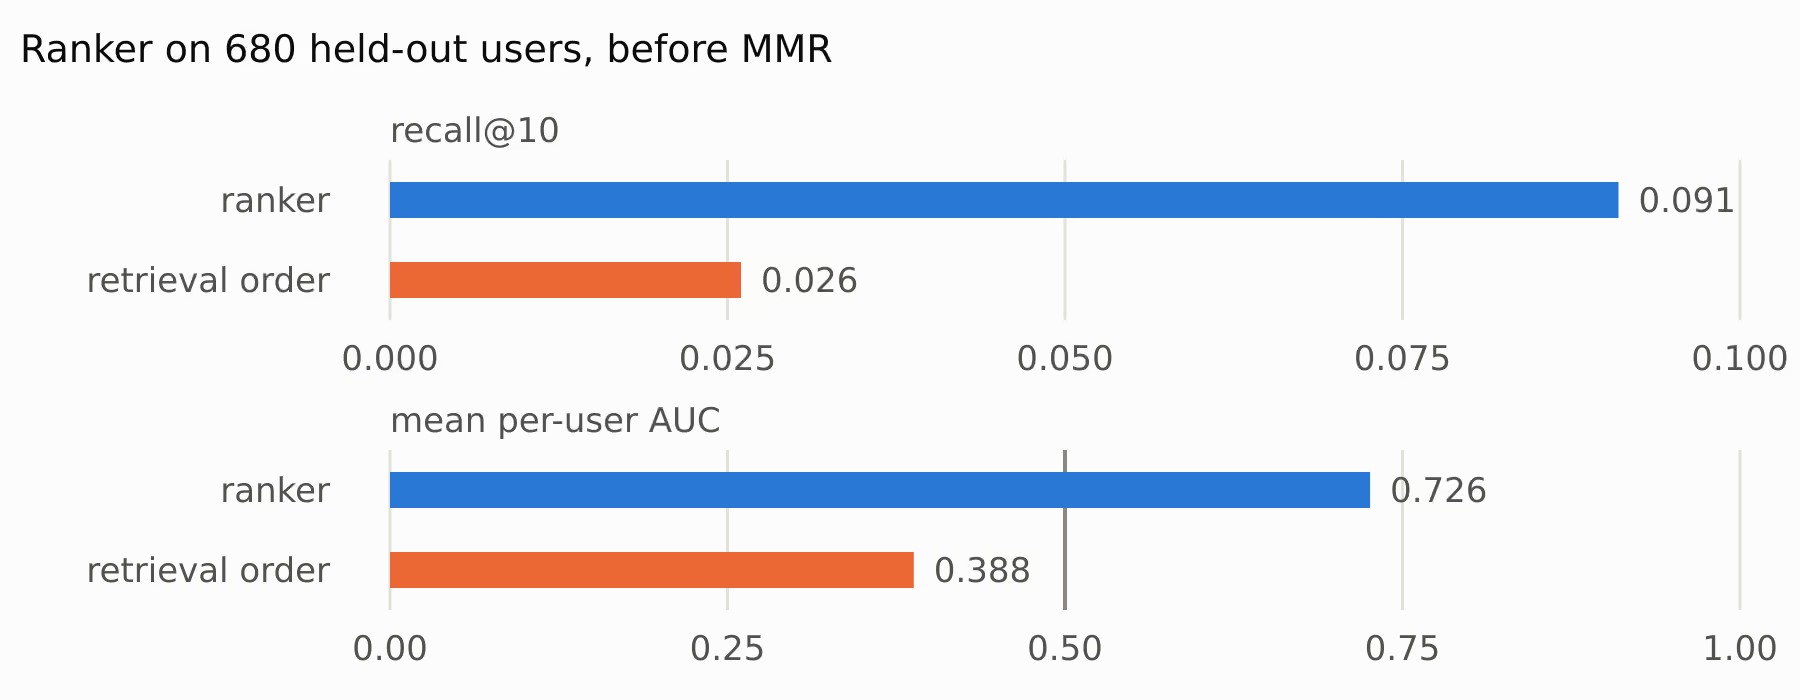
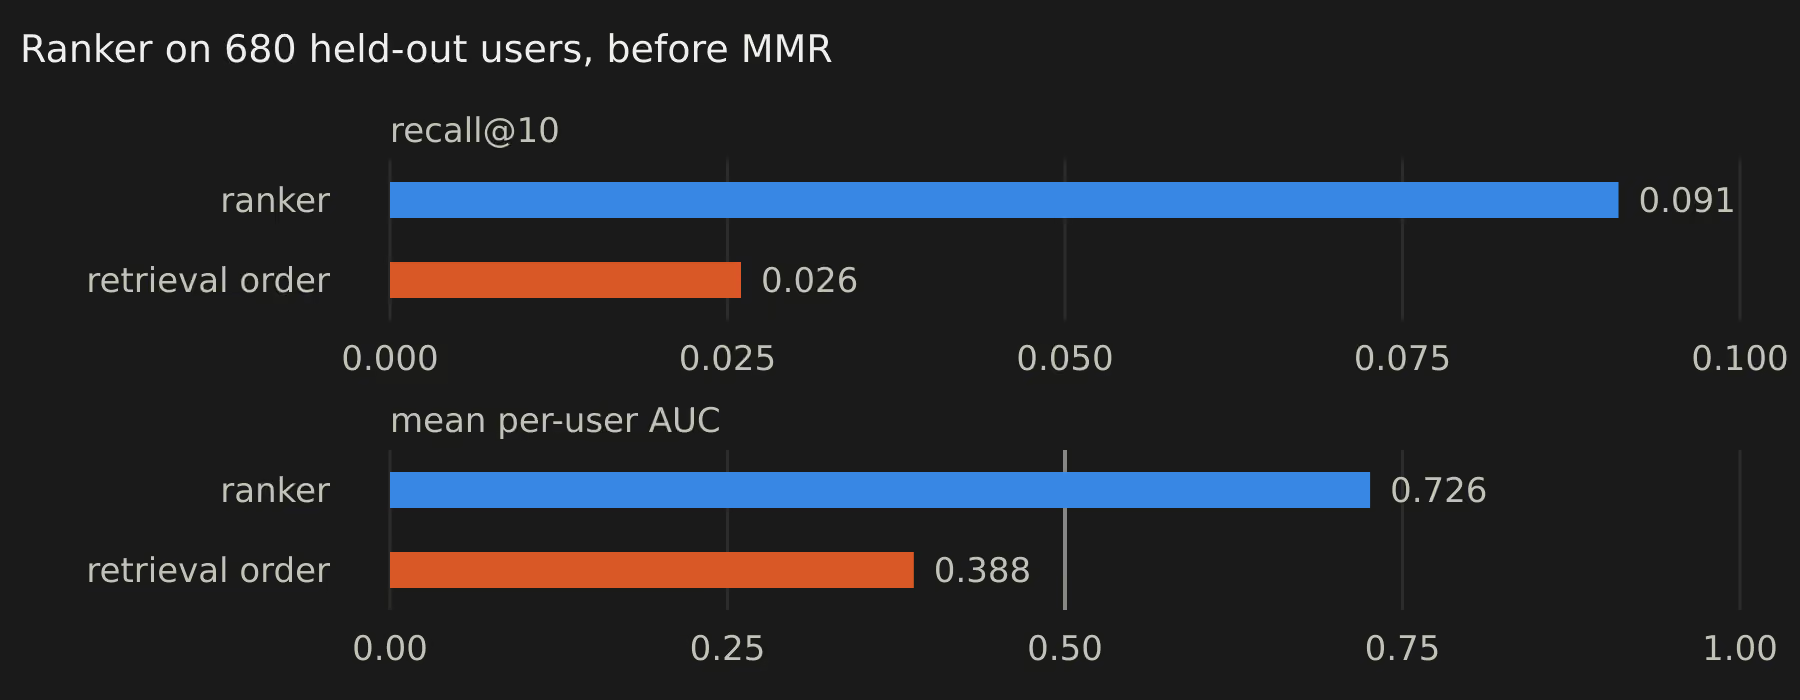
- 逻辑回归排序模型在 680 个留出用户上的 recall@10,召回顺序是 0.026,在 MMR 之前测得。模型给向量分的权重是负的
- 0.091
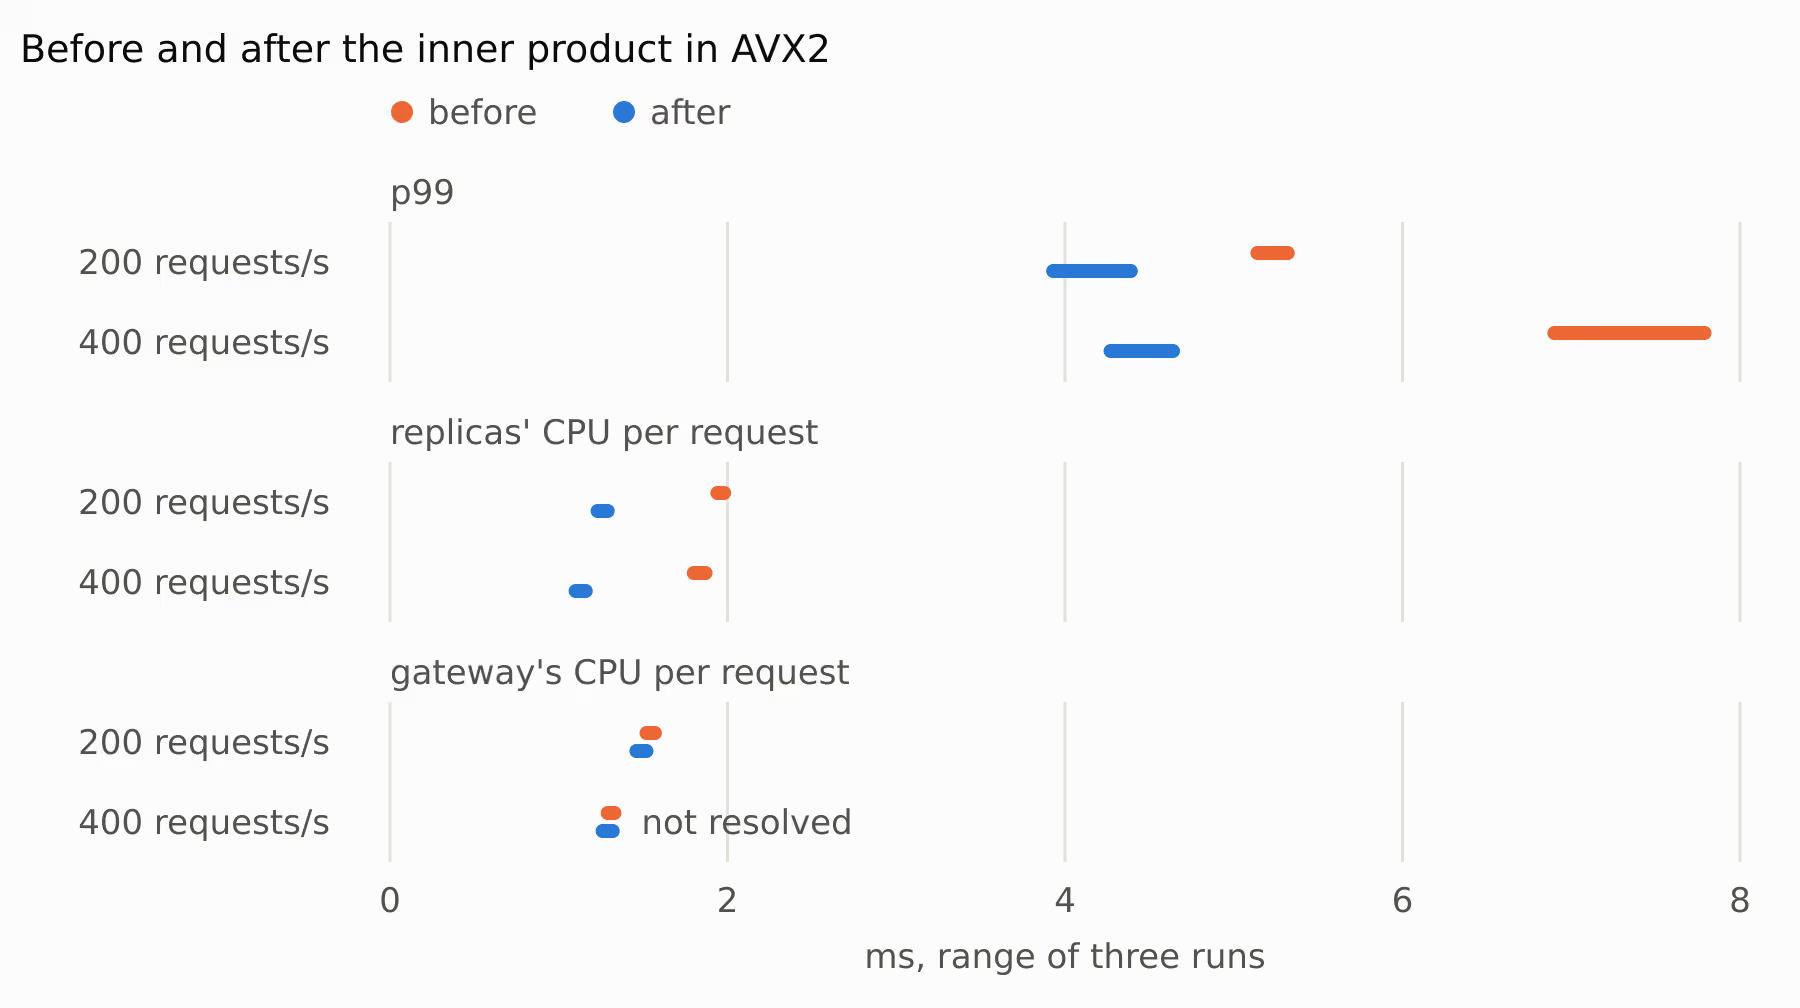
- 精确搜索的内积改用 AVX2 之后,每秒 400 个请求时的 p99,之前是 6.90–7.79 ms,前后各三次运行。这个速率下网关每个请求的 CPU 时间在这台机器上分辨不了
- 4.27–4.64 ms
- 每秒 200 个请求、接上 Valkey 和 Kafka 时,因为读用户历史超出当时 3 ms 的预算(现在是 5 ms)而退回到用请求自带物品的响应占比。另一项检查里四个 CPU 被占满,读用户历史加查缓存这个阶段在需要计算的那一轮,三次运行里有两次 p99 超出 3 ms 的预算,分别是 4.3 和 5.8 ms,另一次是 2.9 ms。这些运行都带着 Kafka 健康检查的负载,它占掉约三分之二个 CPU
- 0.2–0.3%
延迟和负载的数字来自 4 个 vCPU 的云主机。kind 集群只有一个节点,控制面和压测程序都在上面。物品库有 2.56 万个物品,这个规模下精确搜索在单核上约 2 ms,所以分片只是演示机制,速度上并不需要。kind 检查和排序模型的数字在决策记录里(D047、D027)。网关以新版本启动时(如滚动发布),如果一个副本持有运行中网关所用的版本和它之前的版本,并且最后收到的是之前那个版本的搜索或 Prepare,那么启动中的网关让它备好第三个版本时,它会丢掉运行中网关所用的版本。这些网关的搜索转到同分片的下一个副本,直到该副本重新备好这个版本;某个分片没有副本持有这个版本时,这些网关的响应报告 shards_partial,所有分片都如此时报告 vector_error。丢掉版本这一步在一个副本上手工核对过一次。负载扫描(回放,关闭结果缓存,每个速率三次运行)里,每次运行都满足 p99 不超过 50 ms、降级响应不超过 1% 的最高速率是每秒 550 个请求,p99 为 4.6 到 5.1 ms,当时读历史的预算是 3 ms。最近一组故障注入运行(一台 4 vCPU 的虚拟机上每秒 275 个请求,关闭结果缓存,每种故障三次运行)里,四种故障按标准通过,没有错误,故障阶段的 p99 为 6.8 到 20.5 ms:杀掉一个副本、暂停一个副本、一个副本的搜索挂起、一个分片加 50 ms 延迟。Valkey 不可用没有通过:有一次运行用了 7 秒才恢复,标准是 5 秒。暂停 ingest 消费程序没有判定:它有一次运行的几次尝试都无效。负载扫描和这组故障运行来自不同的虚拟机,不互相比较。 基准测试
问题与目标
recserve 是推荐系统的服务端:一个请求在延迟预算内依次经过多路召回、按请求时间点取特征、模型排序和重排。重点是服务工程:延迟、吞吐、可用性、分布式和可观测性。目前它服务的模型都很简单。
目标是测试能说清楚的行为。一个响应绝不会混用两个版本的模型包。每个分片各丢一个副本时,每个响应都与副本全部正常时相同;副本不应答的那种情况,在对冲预算之内成立;它的调用连续五次到分片期限都没应答后,只要同分片另一个副本按时应答,它就被摘除,每秒只再试一次。Valkey 不可用时,每个响应仍然是 200,用请求自带的最近物品,并在响应里说明。同一个事件重复送达多次,不论先后顺序,每个用户历史和每个响应都不变。
规模很小,照实说明。物品库有 2.56 万个物品,这个规模既不需要近似搜索也不需要分片;服务仍然分片,是为了把这套机制跑起来。每次压测都在一台 4 个 vCPU 的虚拟机上跑,所以这些数字反映的是负载下的行为和相对变化,不能用来推断多机部署的容量。
架构
网关(cmd/gateway)加载一个模型包,包的版本号是其中文件的摘要,对外应答 POST /v1/recommend。它先分配 A/B 实验组,经熔断器从 Valkey 读用户历史和结果缓存,用 ONNX Runtime 编码用户,从共现、热门和物品向量三路召回,去掉用户看过的物品,在使用排序模型的实验组里排序,再做 MMR。每个阶段有自己的期限:超时的阶段被跳过或退回备用做法,响应里列出原因。物品向量分成若干分片,由网关自己持有,或者像 compose 和 kind 里那样放在 annshard 副本上经 gRPC 搜索:调用失败立刻转到下一个副本,慢的调用最多补发一次对冲;调用连续五次到分片期限都没应答的副本,在同分片另一个副本按时应答时被摘除,每秒只再试一次。POST /v1/events 把事件写入 Kafka,ingest 消费程序把每个事件幂等地写进用户历史,然后提交。换包时,网关先加载并校验新版本,再让每个副本备好它,每个分片有一个副本备好就可以继续,最后用一次原子写入切换过去。
关键决策
-
D029 每个阶段一个期限,每次退回都给出原因
请求的每个阶段在自己的预算内运行。超时或失败的阶段被跳过或退回备用做法:读不到存储的历史,就把请求自带的最近物品当作历史;没有用户向量,就跳过向量召回;排序模型失败,就保留召回分数。响应里列出这些原因。调用方自己的期限到了,绝不会被报成某个阶段超时。
-
D041 故障立刻转移,对冲受预算限制
一次分片搜索只问一个副本。调用失败时,搜索立刻转到下一个副本。第一个副本 2.5 ms 还没应答时,搜索再问一个副本,取先到的结果。对冲从每个分片自己的令牌桶里取,最多 10 个再加每十次搜索一个,所以慢的副本不会被压上两倍的负载。一个副本的调用连续五次到分片期限都没应答、而同分片另一个副本按时应答时,它就被摘除;之后每秒有一次搜索先问它,它一应答就回到选择里。对冲由网关自己做:grpc-go 实现了重试,没有实现对冲。
-
D042 一个响应绝不会混用两个版本
一个请求只在一个模型包版本上运行,每次分片搜索都带上这个版本号,所以副本要么按这个版本应答,要么失败。换包时网关向每个副本发
Prepare,每个分片至少有一个副本备好新版本才继续;有分片一个都没有,换包就被拒绝,当前版本不变。副本保留两个版本,绝不丢掉最后送达它的Prepare所指定的在用版本。除了换包后约一秒内、有多个网关时,以及副本晚执行了某个Prepare之后,这就是网关在用的版本。 -
D027 排序模型在模型包加载时接受检查
ranker.onnx是六个特征上的逻辑回归。每次调用都传 512 行,所以加载时检查每一行的分数只取决于这一行。模型包带着黄金用例和它们的特征,由计算训练特征的同一份 Python 代码算出;网关用自己的代码重算一遍,只要有一个相差超过 1e-6 就拒绝这个包。排序模型超时或失败时,保留召回分数。 -
D047 kind 检查的是行为,预算设为 100 ms
零错误检查在 kind 的单个节点上跑,节点的 CPU 由控制面、各个 Pod 和压测程序共用。用规格里当时 3 到 15 ms 的预算,完全不做滚动时 24,000 个响应里也有 3 个超时,最慢的一个 22 ms。检查的预算因此设为 100 ms,约是它的五倍,这样降级的响应就意味着失败。用这样的预算,检查看不到滚动对延迟的影响。后来用规格里的预算把同样的滚动和换包跑了三次:没有错误,每个阶段降级的响应最多 0.133%,p99 最高 9.91 ms;这几次只报告不判定,检查仍用 100 ms。
难点与解法
-
网关一直在连旧地址
副本按原名重启后会换一个地址。用 gRPC 默认的 30 秒 DNS 解析间隔,三个网关里有两个在 Pod 被删除 30 秒后才连上新地址,而副本 1 秒后就已就绪;kind 检查里 15,000 个响应有 815 个降级。现在网关允许一个名字在一秒后重新解析,三个网关都在 2 到 3 秒内连上了副本。
-
手写的 HNSW 没有通过自己的延迟标准
先试的纯 Go 库 recall@100 最高只有 0.064,所以索引是手写的。在 glove 上,它只有在 M = 32、ef = 800 时 recall@100 才到 0.95,p99 是 7.66 ms,高于标准里的 5 ms:按写下的标准判为不通过,没有改任何阈值。它的召回率与 faiss 相差不超过 0.007,在 glove 上相同 ef 下的 p99 是 faiss 的 1.0 到 1.3 倍。默认用精确搜索。
-
排序模型给向量分的权重是负的
在 680 个留出用户上,排序模型的 recall@10 是 0.091,召回顺序是 0.026。模型给向量分的权重是负的:在候选里,用户后来选的物品来自共现和热门的多,来自向量分的少。两个数都是在 MMR 之前测的。在进程内离线运行管线,不设阶段预算,含 MMR,在 43,249 个测试事件上 recall@10 是 0.0181;强制排序模型失败、保留召回分数时是 0.0050,相差 −0.0131,按测试事件计算的 95% 区间为 −0.0143 到 −0.0119。强制共现失败时是 0.0098;强制编码器失败时,各项指标的变化都不超过 0.0004。它对用户的实际影响仍要由 A/B 实验来回答。
-
空闲的 Kafka 占掉三分之二个 CPU
在 compose 里,空闲的 Kafka 每秒用掉 639 到 686 ms 的 CPU:它的健康检查每 2 秒启动一次 JVM。带着这个检查做过一次没有留下记录的剖析运行,p99 是 10.97 ms;改成 broker 健康之前每 2 秒检查一次、之后每 10 分钟一次,是 6.41 ms。更早在 compose 里做的压测都带着这份负载,没有重跑。