ope-checks
对已发表的离策略评估结果做预注册检验。第一项研究重测 Open Bandit 基准:在两个确认性活动上,以 10 分钟时间块为重采样单位时,标准估计没有显示出低于在线点击率。
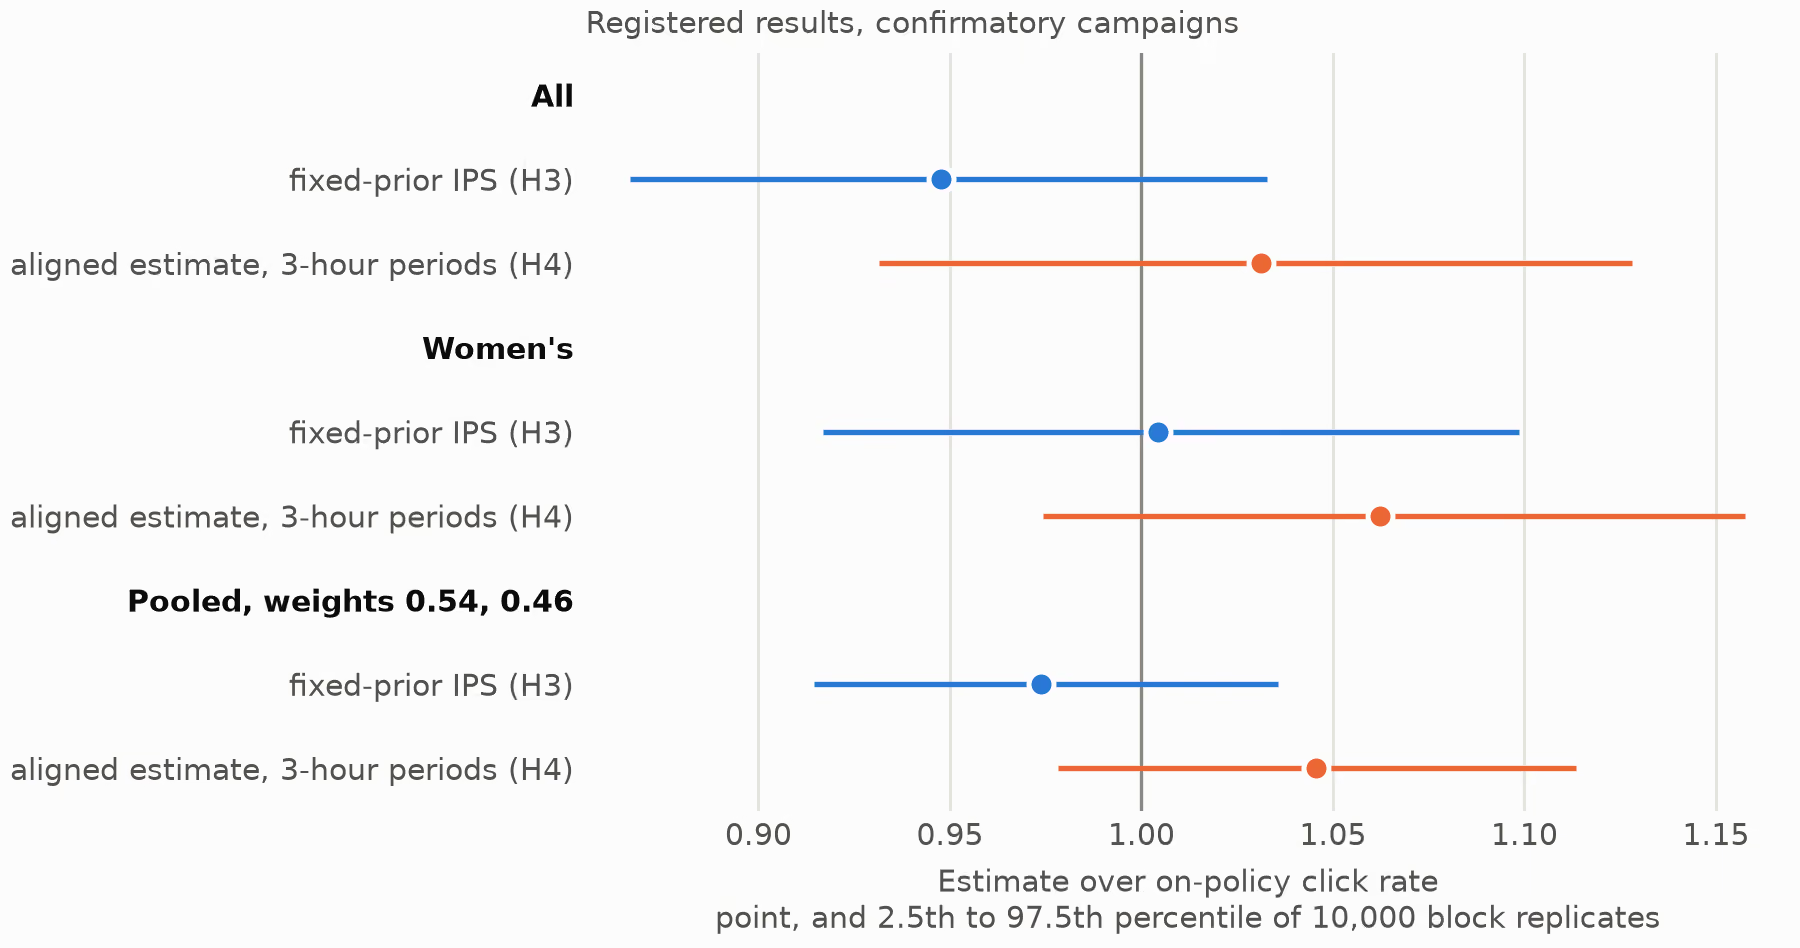
关键指标
- 固定先验的 IPS 估计与在线点击率之比,All 和 Women's 合并,按 10 分钟时间块的区间为 0.915 到 1.036。没有显示出偏低,最多 8.5% 的偏低排除不了
- 0.974
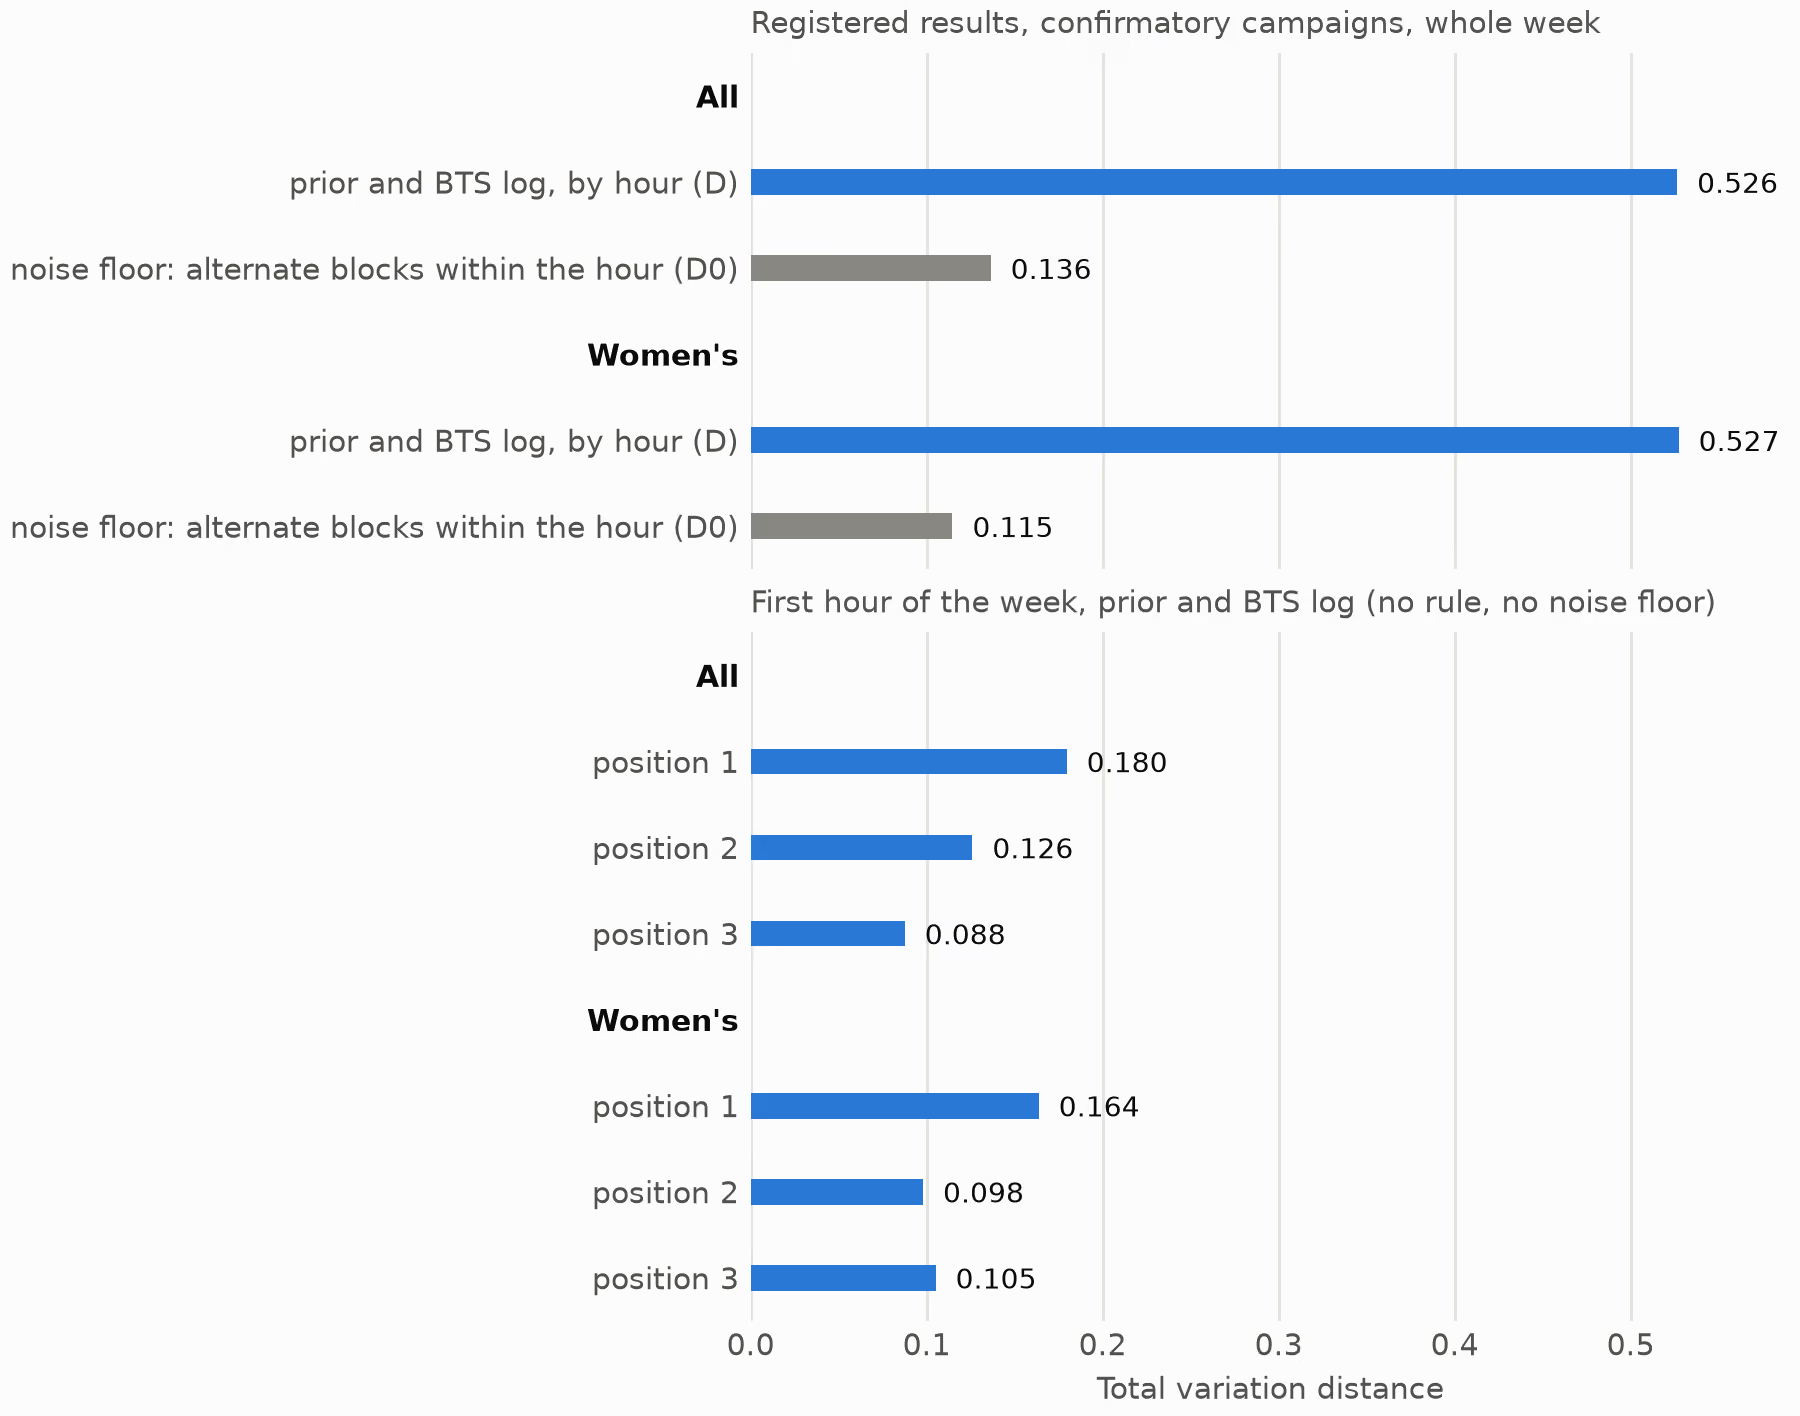
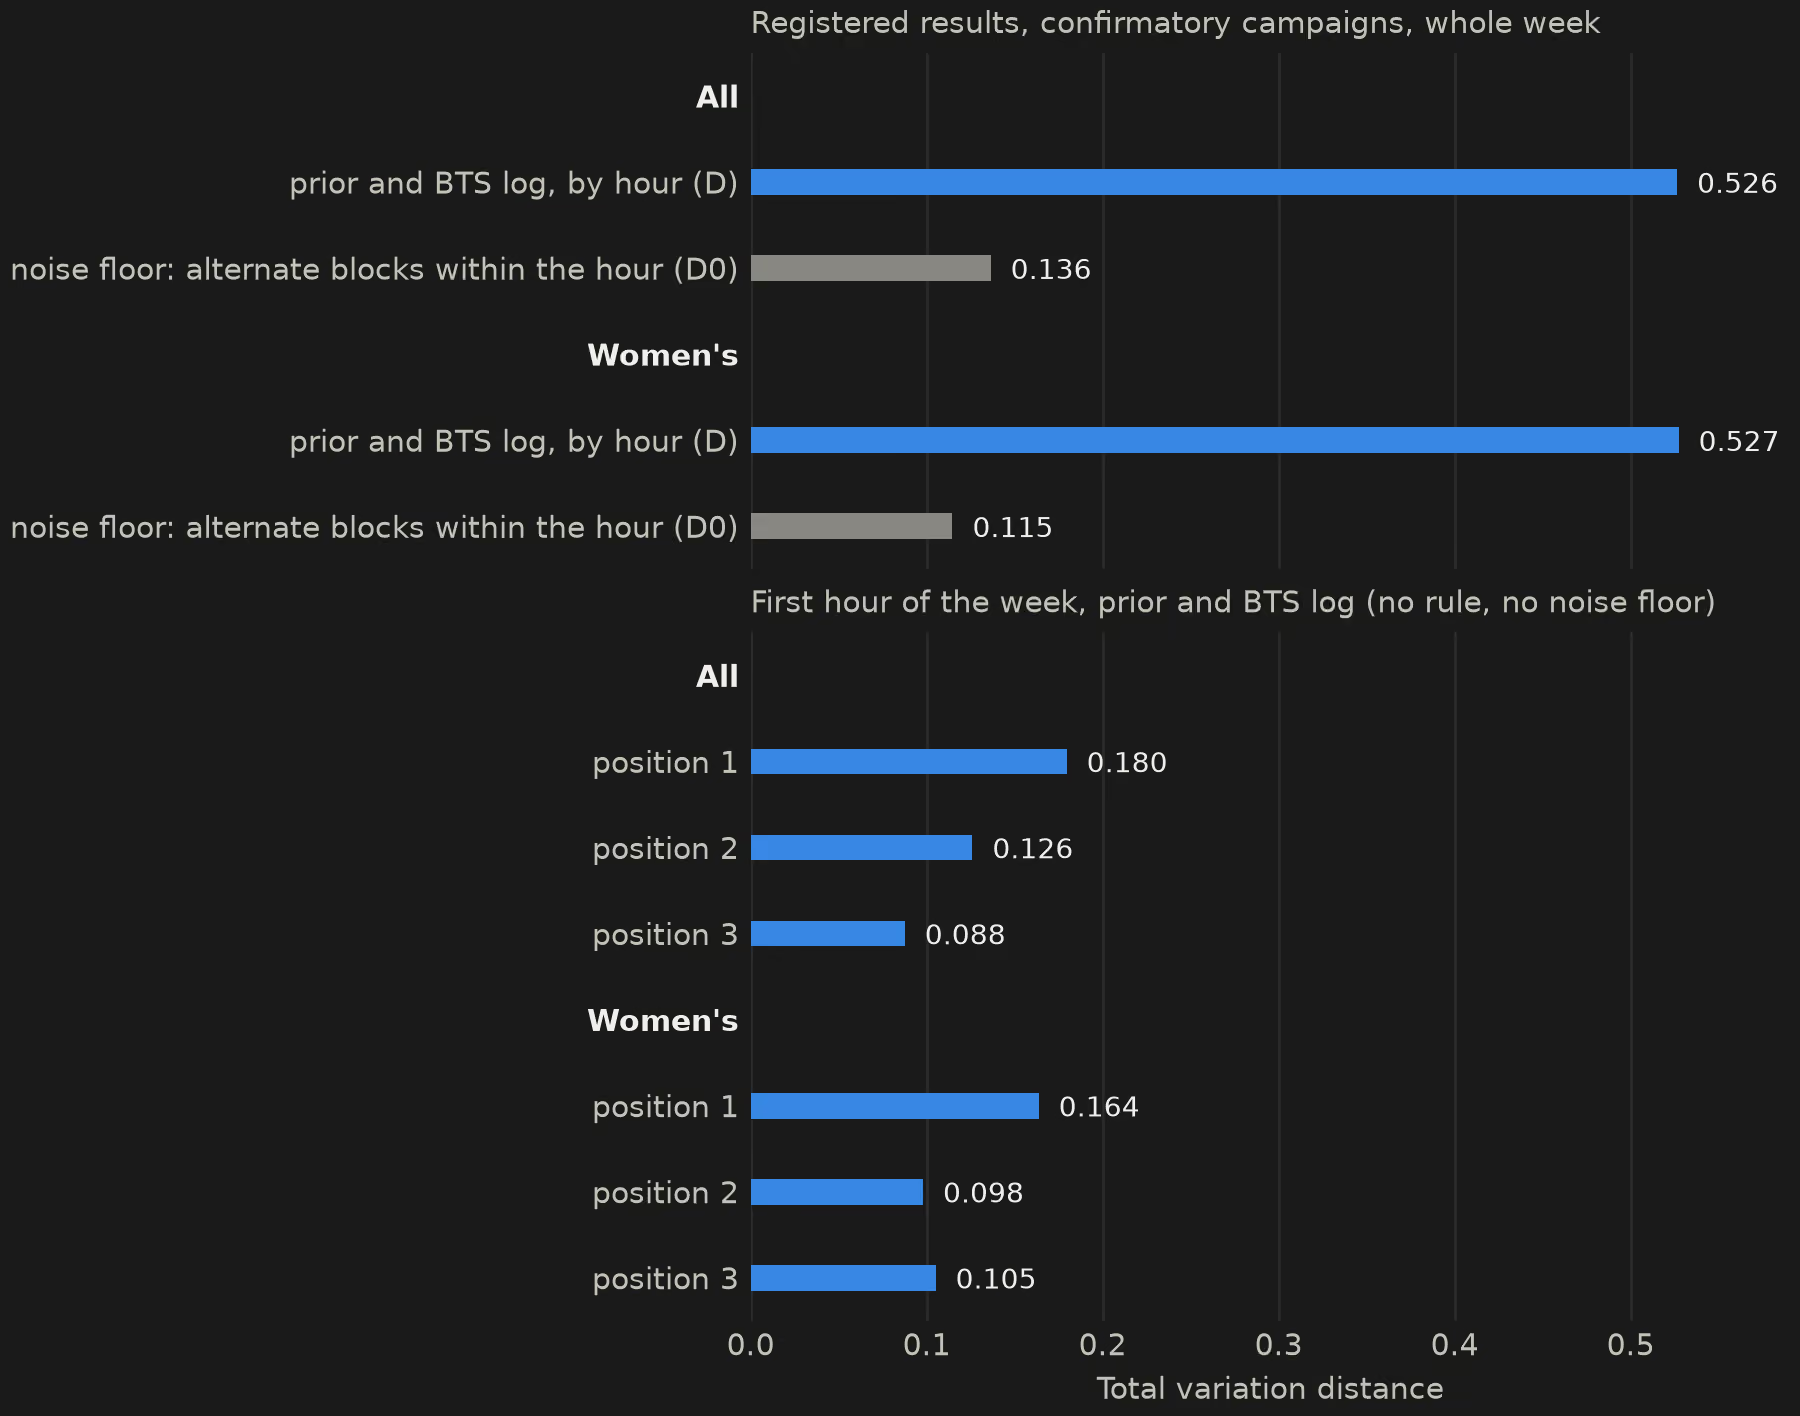
- 公开先验与 BTS 日志中物品频率的距离,All 和 Women's 上都是这个数,噪声底分别为 0.14 和 0.11:先验不是日志实际展示的分布
- 0.53
- 把目标按 3 小时时段对齐到 BTS 日志后,合并估计的配对变化,区间 0.002 到 0.139,事后算得下端离 0 约两个蒙特卡洛标准误;单看 All 或 Women's,区间都包含 0。偏低没有被确立,所以按登记的规则不读差距
- +0.072
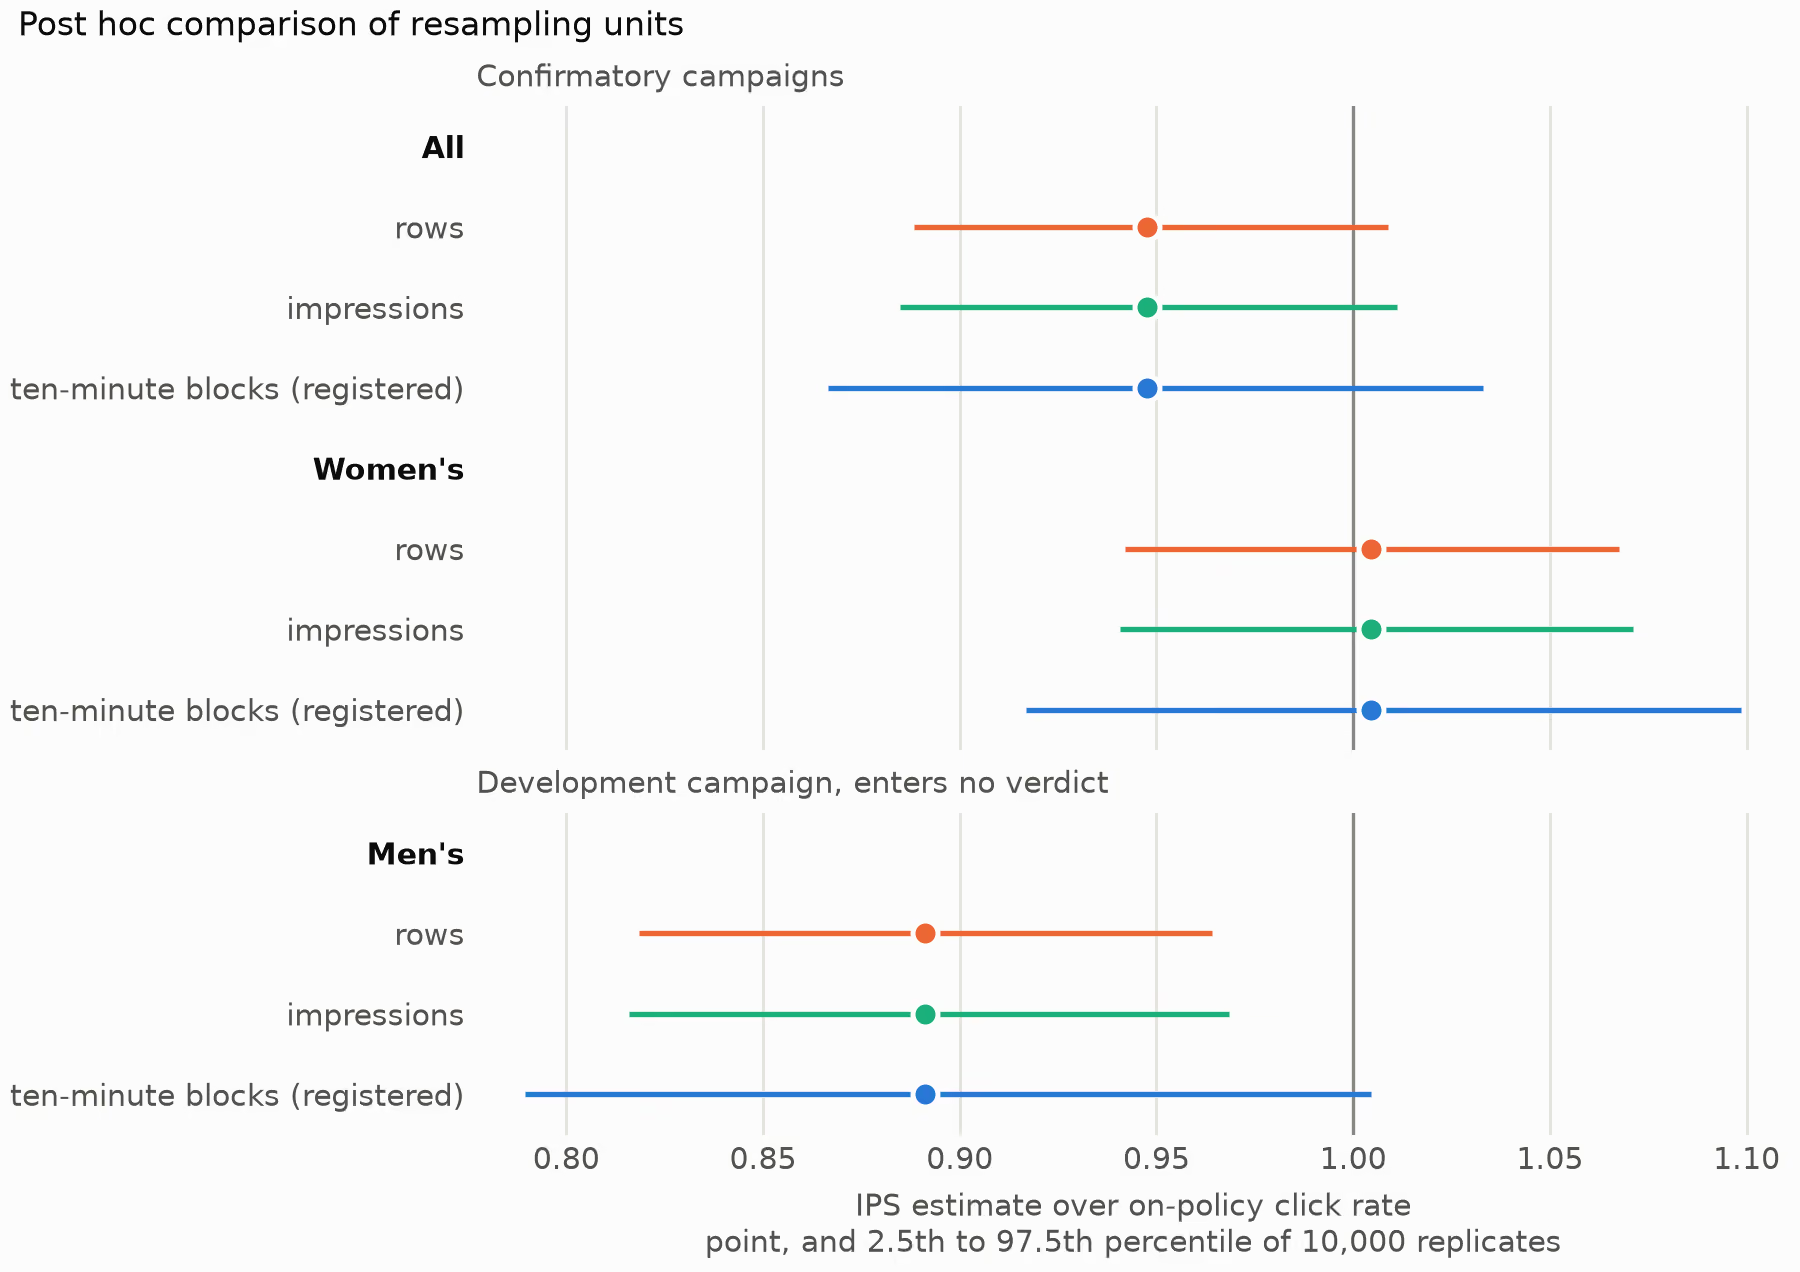
- 按 10 分钟时间块重采样时 H3 比值的标准差,与按行或按曝光重采样时的标准差之比,三个活动都在这个范围内(事后分析)
- 1.31–1.47×
All 和 Women's 上登记的结果来自提交 11e9340 的一次运行。区间是对 10 分钟时间块做 10,000 次重采样的 2.5 和 97.5 百分位;这个块长是看过 Men's 的结果之后定的,预注册里写明了。Men's 是开发用的活动,不进入任何判定,它的 IPS 比值是 0.891(0.790 到 1.005)。最后一格是事后分析。 README 的结果一节
问题与目标
Open Bandit 数据集记录了 ZOZOTOWN 上两个策略一周的日志,一个是均匀随机,一个是伯努利汤普森采样(BTS),分三个活动。它的标准基准用随机日志估计 BTS 的点击率,再和 BTS 日志的点击率比较。在 Men's 活动上,这个估计约为在线值的 0.89。
BTS 的评估目标是按公开的先验算的,而公开的先验并不是日志那一周实际部署的策略。这项研究问的是:差距里有多少来自这个目标。它不问两者为什么不同。
命题、统计量和判定规则在 All 和 Women's 的任何结果算出之前提交;当时 Men's 的结果已知。Men's 是开发用的活动;All 和 Women's 是确认性活动,所有判定都来自在它们上面的一次运行。
架构
data.py 下载数据集压缩包和先验文件,校验它们的 SHA-256,并运行预注册规定的停止检查,这些检查不读任何点击。tables.py 把两份日志的行按 10 分钟时间块求和。estimators.py 把固定先验目标和命题 H1 到 H7 写成这些表的函数,verdicts.py 里是判定规则。run.py 对时间块做 10,000 次 bootstrap 重采样,每次按抽到的次数重新缩放时间块表,再调用同一批估计器;每个活动写一个 JSON 文件,里面有每个统计量、区间和标签,以及产生它的提交号。事后分析放在 obd/posthoc/,结果文件单独存放;图由结果文件画出。
登记的规则
-
§4 一个活动用来开发,两个活动用于判定
Men's 是开发用的活动:代码在它上面写成并检查,它的结果不进入任何判定。在每个命题的代码都在 Men's 上跑过并提交之前,除了行数和不读点击的检查,没有从 All 和 Women's 的文件里算过任何东西。确认性结果来自那个提交的一次运行。
-
§5 以 10 分钟时间块为重采样单位
同一个列表会在几分钟内的多次曝光中重复出现,点击也在几分钟内聚集,所以行和曝光都不独立。一次重采样有放回地抽 1,008 个 10 分钟时间块,一个时间块带着两份日志落在其中的所有行。
-
H3 整个区间低于 1 才算偏低
对每个单元和每个估计器:比值(估计与在线点击率之比)的区间整个低于 1,标签是
low;整个高于 1,是high;其余情况是no shortfall shown。在 All、Women's 和合并单元上,IPS 和 SNIPS 的标签全部是no shortfall shown。 -
H4 只有发现偏低的地方才读差距
H4 是主命题,它把先验换成 BTS 日志在同一时段的实际频率。对差距的读法只适用于 H3 把 IPS 判为
low的单元。没有一个单元是这样,所以每个单元的读数都是shortfall not established; gap not read。 -
A7 一个特征取值在两份文件里写法不同
两份日志文件里的用户特征是哈希过的,每个特征各有一个取值在两份文件里写法不同。修订 7 在任何确认性结果算出之前定下:如果恰好有一个取值只出现在其中一份文件、恰好有一个只出现在另一份,就把这两个当作同一个取值。在每个确认性活动上,四个特征里有三个这样配上了;第四个按原样比较,所以登记的两份日志用户之间的距离(0.360 和 0.236)不能读成用户构成的差别。
局限
-
没有显示不等于不存在
合并区间的下端是 0.915,所以按 10 分钟时间块,最多 8.5% 的偏低排除不了。事后按 3 小时时间块,合并区间是 0.897 到 1.056。开发用的活动上比值是 0.891(0.790 到 1.005),它不进入任何判定。
-
块长是看过开发集结果之后定的
块长和 H1 的阈值是看着 Men's 的结果定下的。数据里没有用户标识,所以跨出一个 10 分钟时间块的依赖,比如同一个用户一天里的多次访问,没有进入区间。
-
主问题没有读数
这项研究原本要量的是:差距里有多少可以归到评估目标上。在确认性活动上偏低没有被确立,按登记的规则不读差距,所以这个问题没有答案。对齐后的估计在每个单元上都与在线值无法区分;它相对固定先验 IPS 的配对变化,只有在合并单元上区间不含 0,那里区间下端是 0.002。
-
公开数据答不了的事
任一时刻生效的 Beta 参数、更新间隔、每一行是哪个版本提供的,数据里都没有。BTS 日志记录的倾向分是否自洽,在两个活动上都是 undetermined。All 不是相对开发用活动的干净留出集:结果出来之后做的一项不读点击的核对发现,先验文件里 Men's 的 34 对 Beta 参数原样、按原顺序出现在 All 的 80 对里,Women's 的 46 对一对也没有。
-
覆盖率只在模拟的点击上数过
另一项单独登记的半合成研究(
obd_coverage/)保留日志的每一行,按已知的过程生成点击,这样就能数出名义 95% 区间的覆盖率。依赖延伸到一两分钟、强度由日志的已发表统计量解出时,All 和 Women's 上 IPS 比值的区间按行或按曝光重采样覆盖 0.85 到 0.88,按 5 到 180 分钟的时钟块覆盖 0.945 到 0.953;这是对短程依赖的上限读法:已发表的方差比里如果有一部分来自点击率本身在变,按行和按曝光的覆盖率会更高。再加上跨一小时的会话组,十分钟块在 All 上覆盖 0.907,在 Women's 上覆盖 0.850;会话组跨一天时,没有任何块长达标。这两种情形本来就调成真实方差超过十分钟块能看到的部分,所以十分钟块在其中覆盖不足是意料之中的。Women's 上已发表的区间变宽(到 180 分钟为止)超出了短程情形能产生的范围,所以它的十分钟区间没有显示达到覆盖率。这项研究并没有表明真实日志具有其中任何一种结构。 -
重新打分的标签适用范围
另一项研究
obd_rescore把两个已发表的估计器比较,按R_IPS重新打分,也按V_on(BTS 日志的点击率)重新打分;R_IPS是被评估目标在整个随机日志上的 IPS,对目标的价值无偏。它的预注册在已发表比较的任何代码于这份数据上运行之前提交,两个复现都是reproduced。在 All 上,以 10 分钟时间块为单位、目标施加在各自的(物品,位置)对上时,MIPS (w/ SLOPE) 相对 IPS 在R_IPS之下是flips:它在 500 次运行中有 91 次更接近。在 Men's 上,BLUE - IPS在 2,000 次时间块重采样上的区间是 0.000107 到 0.000898,不含 0,所以“BLUE 保持无偏”在数据的完整规模下是contradicted,奖励模型和目标固定;在 All 和 Women's 上是not contradicted,这不能说明 BLUE 无偏。flips不能说明 MIPS (w/ SLOPE) 总体上更差。标签描述的是每个协议的重采样,参照固定在全数据值,并以 10 分钟时间块为基础;BLUE 的奖励模型在全部数据上只拟合一次。